Seata Saga 学习笔记:状态机编排的分布式长事务
我们银行的 core 系统,到现在还跑在那台老 mainframe 上。最近组里在推现代化改造,要把它慢慢搬出来,换成新的分布式架构。这事儿一上手我就懵了——我对分布式事务本来就不熟,什么 AT、TCC、Saga、XA 以前只听过个名字。
没办法,现学。Seata 是这阵子重点在看的分布式事务框架,其中 Saga 模式又跟我们的迁移场景格外对得上:老核心改不动,只能走它暴露出来的接口,还得保证数据最终能对上。所以这篇算是我的学习笔记,边学边记,里面要是有理解得不对的地方,欢迎拍砖。
一、先把四种模式认个脸
Seata 给了四种模式:AT / TCC / Saga / XA。我一开始是真分不清,后来发现区分点其实很现实——就看”参与者你能不能改、要不要锁资源”:
- AT:几乎零侵入,框架自动帮你记
undo_log回滚。但前提是参与者得是支持本地事务的关系型库,而且你能在它身上动刀。我们那台老 mainframe?想都别想。 - TCC:业务侵入强,得自己写 try/confirm/cancel 三件套。性能好,但同样要求你能改参与方的逻辑。
- Saga:长流程、跨系统、改不动的参与者,它的主场。每步只管调接口,再配一个补偿操作。
- XA:基于协议的强一致,但资源锁到提交,性能差,低并发传统场景才用。
为了不让自己犯晕,我还是整理了一张表(初学时这张表确实帮了我):
| 模式 | 侵入性 | 要全局锁吗 | 适合啥 | 一致性 |
|---|---|---|---|---|
| AT | 几乎无(自动 undo_log) | 要 | 大多数 OLTP、关系型库 | 强一致 |
| TCC | 强(手写 try/confirm/cancel) | 不要 | 核心高并发、资源能锁 | 强一致 |
| Saga | 中(得写补偿) | 不要 | 长流程、跨系统、老服务 | 最终一致 |
| XA | 无(靠协议) | 要(锁到提交) | 传统强一致、低并发 | 强一致 |
扯句题外话:Saga 这概念比 Seata 老多了,来自 1987 年一篇叫 Sagas 的论文。Seata 用的是其中的”编排式(Orchestration)”思路——找个中心状态机统一调度,而不是让各个服务互相喊话(那种叫”协同式”)。这段是我查资料补的,不一定全对。
二、Saga 到底在想什么
我一开始以为 Saga 也是两阶段提交那种,后来才搞懂它压根不锁定资源,一阶段就直接提交,靠”事后补偿”来兜底。核心思路其实不复杂:
把一件大事拆成一串本地小事务,每走一步都备好一个”后悔药”(补偿操作);哪一步翻车了,就倒着把前面干过的全撤销一遍。
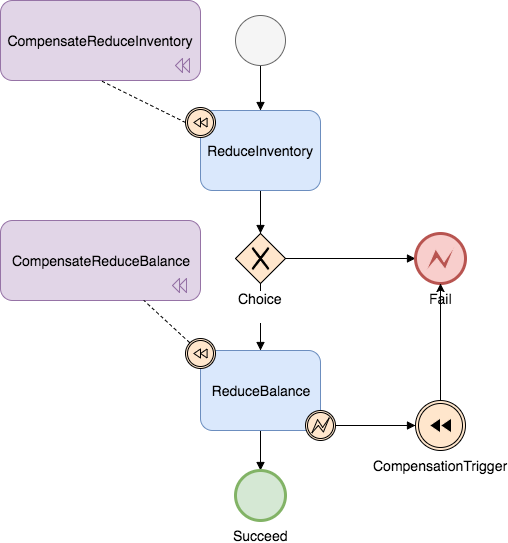
拿”下单”举个最直白的例子,正向链路长这样:
正向执行(一步步往下推):
  扣库存  →  扣余额  →  创建订单  →  成功

假设"扣余额"挂了,那就倒着补偿(后进先出):
  补偿扣余额  →  补偿扣库存
这几个点我自己当初绕了好久才理顺:
- **每个状态都有”向前服务”和”补偿服务”**。比如”扣库存”对应
reduce(),它的后悔药就是compensateReduce()(把库存加回去)。 - 失败是倒着补偿的(后进先出)。谁最后成功谁先被撤。上面例子里扣库存已经成了、扣余额挂了,那就只撤扣余额和扣库存,订单还没建所以不用管。
- 补偿本身也得幂等、能重入。网络抽风可能让补偿被重试好几遍,你的补偿逻辑得经得起这么折腾。
- **还得防”空补偿”**:有时候向前服务还没真跑起来(比如超时了),补偿请求倒先到了,这时候补偿逻辑得能认出来,别瞎报错。
把这套用 Seata Saga 落地,核心就是一个 状态机(State Machine)。
三、Seata Saga 怎么转起来的
Seata Saga 主要靠这么几个角色撑着(这块我也还在消化,先按我的理解写):
- StateMachineEngine(状态机引擎):直接嵌在你应用里的那个”大脑”,负责加载状态机定义、推动流程、失败了触发补偿、并把整个过程记下来。
- Statelang(状态语言):用一段 JSON 把整个状态机描述出来——有哪些状态、每个状态调哪个服务、失败补偿谁、下一步去哪。手写 JSON 嫌烦也行,官方还给了个 Seata Saga Designer(基于 Eclipse 的拖拽工具)画完再导出。
- 持久化日志:状态机的定义和每次执行的轨迹都会落库。这点我觉得特别关键——正因为它把日志写进库了,应用崩了重启能从断点接着跑,把没跑完的补偿补完。像我们这种迁移期系统,最怕半夜崩了卡在半路,这个恢复能力是刚需。
跟 AT / TCC 不一样,Seata Saga 的状态机引擎是内嵌在你应用里的,协调和恢复全靠自己那几张表完成,所以通常不需要像 AT/TCC 那样额外挂一个 TC(Seata Server)去协调全局事务,部署上轻不少。这点我一开始也没想到,还以为所有模式都得挂个 TC。
补一句免得误导:官方不同版本的示例里,有的 Demo 还是让你先”启动 Seata Server”(尤其是跟 Dubbo / Spring Cloud 集成的那类例子)。所以到底要不要 TC,以你实际用的 Seata 版本和集成方式为准——我这里是按”引入 seata-saga 独立跑状态机”这个用法来理解的。
Saga 需要这几张表(建表 SQL 随 Seata 发行包走,一般在 seata/script 下,找 saga 相关的那几个):
seata_state_machine_def—— 状态机定义seata_state_machine_inst—— 状态机执行实例seata_state_inst—— 单个状态执行记录(恢复就靠它)
就这三张。我一开始以为还有第四张 seata_state_inst_log,对着官方脚本数了一遍才发现没有,是我记岔了。
四、动手:写个下单扣库存的 Saga
光看概念我总觉得飘,还是得敲一遍才踏实。下面用”下单时依次扣库存、扣余额、创建订单,任一步失败就把前面已成的步骤反向补偿”这个例子,把一条完整链路搭出来。这跟我理解里”新系统调老核心接口”的情形其实差不多。
1. 先把依赖加进来
<dependency>
    <groupId>io.seata</groupId>
    <artifactId>seata-saga-spring</artifactId>
    <version>2.0.0</version> <!-- 换成你实际用的 Seata 版本 -->
</dependency>
2. 写状态机 JSON
在 resources/statelang/ 下新建 createOrderSaga.json:
{
  "Name": "createOrderSaga",
  "Comment": "下单时依次扣库存、扣余额、创建订单,任意环节失败则反向补偿",
  "StartState": "ReduceInventory",
  "Version": "1.0.0",
  "States": {
    "ReduceInventory": {
      "Type": "ServiceTask",
      "ServiceName": "inventoryService",
      "ServiceMethod": "reduce",
      "CompensateState": "CompensateReduceInventory",
      "Next": "ReduceBalance",
      "Input": ["$.[inventoryId]", "$.[count]"],
      "Output": { "inventoryStatus": "$.#root" },
      "Status": { "#root == 0": "SU" }
    },
    "CompensateReduceInventory": {
      "Type": "ServiceTask",
      "ServiceName": "inventoryService",
      "ServiceMethod": "compensateReduce",
      "Input": ["$.[inventoryId]", "$.[count]"]
    },
    "ReduceBalance": {
      "Type": "ServiceTask",
      "ServiceName": "accountService",
      "ServiceMethod": "reduce",
      "CompensateState": "CompensateReduceBalance",
      "Next": "CreateOrder",
      "Input": ["$.[userId]", "$.[amount]"],
      "Output": { "balanceStatus": "$.#root" }
    },
    "CompensateReduceBalance": {
      "Type": "ServiceTask",
      "ServiceName": "accountService",
      "ServiceMethod": "compensateReduce",
      "Input": ["$.[userId]", "$.[amount]"]
    },
    "CreateOrder": {
      "Type": "ServiceTask",
      "ServiceName": "orderService",
      "ServiceMethod": "create",
      "CompensateState": "CompensateCreateOrder",
      "Next": "Succeed",
      "Input": ["$.[userId]", "$.[inventoryId]", "$.[count]"],
      "Output": { "orderId": "$.#root" }
    },
    "CompensateCreateOrder": {
      "Type": "ServiceTask",
      "ServiceName": "orderService",
      "ServiceMethod": "cancel",
      "Input": ["$.[orderId]"]
    },
    "Succeed": {
      "Type": "Succeed"
    }
  }
}
第一次看这段 JSON 我是懵的,后来对着字段一个个对才明白:CompensateState 就是”这步挂了找谁擦屁股”,Next 是”成了去哪步”,Input/Output 是参数怎么进出。
3. 写正向 / 补偿服务
服务以 Spring Bean 的形式存在,状态机按 ServiceName 找到它,方法参数顺序得和 JSON 里的 Input 对上:
@Service("inventoryService")
public class InventoryService {
    /** 正向:扣库存,返回 0 算成功 */
    public int reduce(String inventoryId, int count) {
        // TODO: 真正的扣库存逻辑
        return 0;
    }

    /** 补偿:把库存加回去(务必幂等) */
    public void compensateReduce(String inventoryId, int count) {
        // TODO: 恢复库存逻辑
    }
}

@Service("accountService")
public class AccountService {
    public int reduce(String userId, BigDecimal amount) { return 0; }
    public void compensateReduce(String userId, BigDecimal amount) { }
}

@Service("orderService")
public class OrderService {
    public String create(String userId, String inventoryId, int count) { return "order_123"; }
    public void cancel(String orderId) { }
}
4. 装配引擎和模板
把状态机引擎和调用模板配好,指到持久化的那个数据源:
@Configuration
public class SeataSagaConfig {

    @Bean
    public StateMachineEngine stateMachineEngine(DataSource dataSource) throws Exception {
        DbStateMachineConfig config = new DbStateMachineConfig();
        config.setDataSource(dataSource);                          // 状态机定义 + 执行日志都落这
        // 注意:这里要传 Spring 的 Resource[],不是字符串数组
        config.setResources(new PathMatchingResourcePatternResolver()
                .getResources("classpath*:statelang/*.json"));
        config.setEnableAsync(true);                               // 异步跑,吞吐好点
        DefaultStateMachineEngine engine = new DefaultStateMachineEngine();
        engine.setStateMachineConfig(config);
        engine.init();                                             // 启动就加载状态机定义
        return engine;
    }

    @Bean
    public SagaTransactionalTemplate sagaTransactionalTemplate(StateMachineEngine engine) {
        SagaTransactionalTemplate template = new SagaTransactionalTemplate();
        template.setStateMachineEngine(engine);
        return template;
    }
}
SagaTransactionalTemplate 这个东西我琢磨了一会儿才懂:它就是把”启动状态机 + 包一层事务上下文”封装好了,你只要 execute(...) 丢进去就行。
5. 发起调用
@Autowired
private SagaTransactionalTemplate sagaTransactionalTemplate;

public String createOrder(OrderCmd cmd) {
    Map<String, Object> startParams = new HashMap<>();
    startParams.put("inventoryId", cmd.getInventoryId());
    startParams.put("count", cmd.getCount());
    startParams.put("userId", cmd.getUserId());
    startParams.put("amount", cmd.getAmount());

    String businessKey = "createOrder_" + cmd.getOrderId();        // 业务主键,幂等和查账用
    StateMachineInstance inst = sagaTransactionalTemplate.execute(
            "createOrderSaga",   // 状态机名,对应 JSON 的 Name
            null,                // tenantId
            businessKey,
            startParams);

    if (ExecutionStatus.SU.equals(inst.getStatus())) {
        return "下单成功,订单号:" + inst.getEndParams().get("orderId");
    } else {
        throw new RuntimeException("下单失败,已自动补偿,状态=" + inst.getStatus());
    }
}
6. 补偿到底是怎么发生的?
假设 accountService.reduce() 抛了个异常:
- 引擎逮住异常,把
ReduceBalance标记为失败; - 顺着
CompensateState往回找,依次调CompensateReduceBalance、CompensateReduceInventory; - 每步补偿的结果也写进日志;
- 最后状态机实例变成
FA(失败),对调用方来说就是”下单没成,而且已经回滚干净了”。
要是进程跑到一半崩了,重启之后引擎会扫一遍没跑完的实例,照着 seata_state_inst 里记下的轨迹把补偿接着跑完——这就是前面说的”持久化”的意义,也是迁移期最看重的兜底。
五、状态机 JSON 里我目前记下来的字段
不用全记,先把常用的混个脸熟,自己写的时候对着填就行:
| 字段 | 干啥用的 |
|---|---|
Name / Version / StartState |
状态机名字、版本、从哪个状态进门 |
Type |
状态类型:ServiceTask(调服务)、Choice(分支)、Succeed/Fail(成功/失败收尾)、CompensationTrigger(触发补偿)、SubStateMachine(子状态机)、ScriptTask(脚本) |
ServiceName / ServiceMethod |
要调的服务 Bean 名和方法名 |
CompensateState |
这个状态挂了之后对应哪个补偿状态 |
Next |
成功了下一步去哪 |
Input / Output |
入参/出参映射,用 JSONPath 表达式(如 $.[count]、$.#root 指返回值) |
Status |
把业务返回码翻译成状态(SU 成功、UN 未知待重试、FA 失败触发补偿,具体看版本的 ExecutionStatus 枚举) |
Retry |
重试策略:Exceptions、MaxAttempts、IntervalSeconds、BackoffRate |
Catch |
抓异常、走别的支路 |
Choice 状态能根据上下文分叉,比如按金额走不同风控;SubStateMachine 可以把一段复杂子流程抽出来复用。这俩凑一块,描述个挺复杂的业务编排也不在话下。具体的我还没用到,先记着。
六、到目前为止我对 Saga 的几点感受
香的地方
- 不要求参与者支持本地事务,能拉上老系统、第三方一起进事务——我们迁移期调老核心的接口就靠它;
- 一阶段直接提交,没全局锁,长流程下响应和吞吐都舒服;
- 崩了能恢复,靠持久化日志兜底最终一致。
得留神的坑
- 隔离性弱:两个 Saga 并发改同一份资源,可能脏读、丢更新。能缓解的手段有语义锁、重读校验、版本号、对冲(countermeasure)这些,我也还在看。
- 补偿逻辑得自己写,而且要保证幂等、可重入,还得接住”空补偿”(向前没跑却收到补偿)。
- **可能冒出”未知状态”**:服务超时了,到底成没成不知道,这种
UN状态往往得人工兜底,或者上定时任务去对账、重试。 - 跟 AT 那种”几乎零侵入”比,Saga 对业务的侵入在于:你每一步都得自己设计补偿语义。
一句话:Saga 把”一致性”的活儿从框架肩上,挪到了你自己的业务设计上。它不替你做补偿,只是保证补偿会被可靠地、按顺序地执行——剩下的脑仁疼,得你来。
七、收个尾
- Seata 的 Saga 模式,是给长流程、跨系统、还有改不动的参与者准备的分布式事务方案,跟我们搬离老核心这段迁移期特别对得上。
- 它的核心是状态机:用 JSON 写清”正向步骤 + 补偿步骤”,引擎推着跑,挂了就反向补偿。
- 它内嵌在应用里、靠 DB 日志恢复,一般不用单独部署 Seata Server。
- 代价是隔离性弱、补偿得自己保证幂等——适合”最终一致”能接受的场景,而不是强一致核心交易。
笔记先记到这。分布式这块我也是刚入门,上面要是有说错的地方请多包涵,欢迎指正。等真正在迁移里用上了,估计还得回来补一篇实战踩坑。
参考文档:Seata 官方文档 · Seata Saga 用户手册