OceanBase 学习笔记(二):租户、资源与 SQL 实战
上篇把 OB 在 Docker 里跑起来、连上 sys 租户看了一眼,算是”能开机了”。但 sys 是系统租户,不是给你放业务数据的——真正要用起来,得先搞懂 OB 的多租户和资源模型,这也是它和我以前用的单机库差别最大的地方。这篇就接着讲:怎么建一个业务租户、客户端怎么连、以及数据到底是怎么”散”到各节点去的。
仍然是学习笔记,不是官方手册。里面建租户的命令我标了”以你本地环境为准”,因为 MINI_MODE 单机环境的 zone 名、可用资源跟我这边不一定一样,照抄前先
SHOW ZONES;看一眼。
1. 先搞懂三层模型:租户 / 资源池 / Unit
我一开始以为”连上数据库就能建库开干”,结果被现实教了——OB 里资源是分层管的:
- Unit(资源单元):描述”在某台 OBServer 上分给某个租户多少资源”的容器,含 CPU、内存、日志盘大小。可以类比成一个轻量虚拟机。
- Resource Pool(资源池):由一个或多个同规格的 Unit 组成,绑定到指定的 Zone 上,然后整体分配给某个租户。
- Tenant(租户):最终给业务用的独立数据库实例,能选 MySQL 或 Oracle 兼容模式,它手里的资源就来自拥有的 Resource Pool。
所以整条关系是:Cluster → Tenant → Database → Table,而 Unit / Pool 是”资源怎么切、分给谁”的载体。建业务租户的正确顺序是 先 Unit,再 Pool,最后 Tenant,跳过前两步直接 CREATE TENANT 会报错——这是我踩的第一个坑。
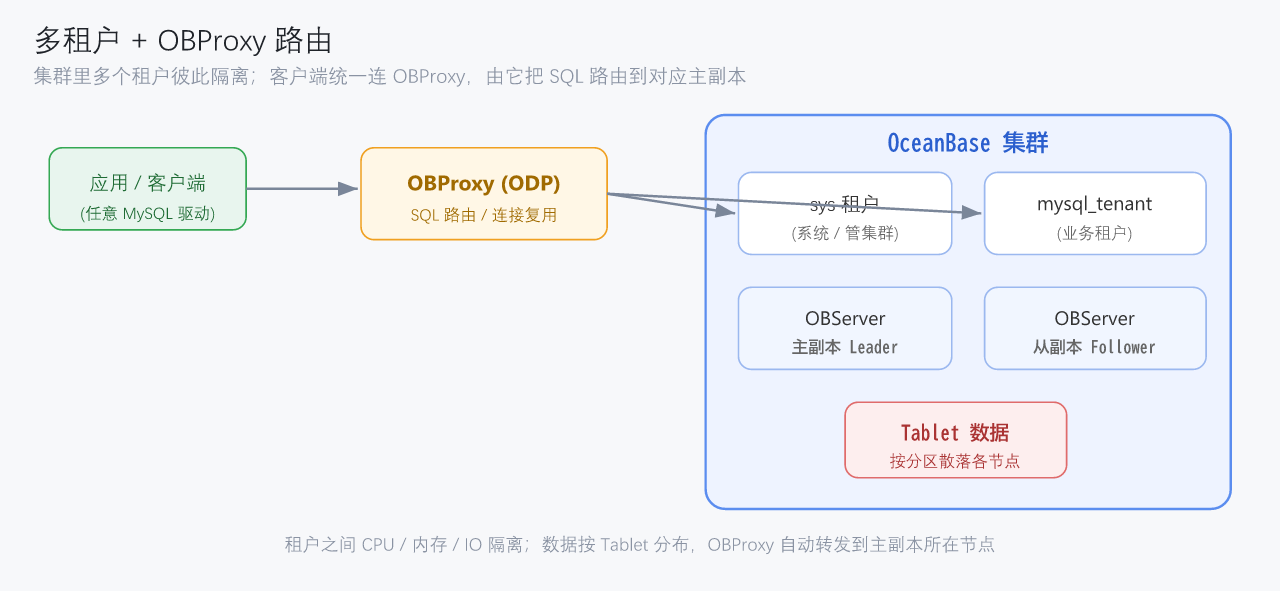
把这几层关系画出来,配合后面 OBProxy 的路由,会清楚很多:
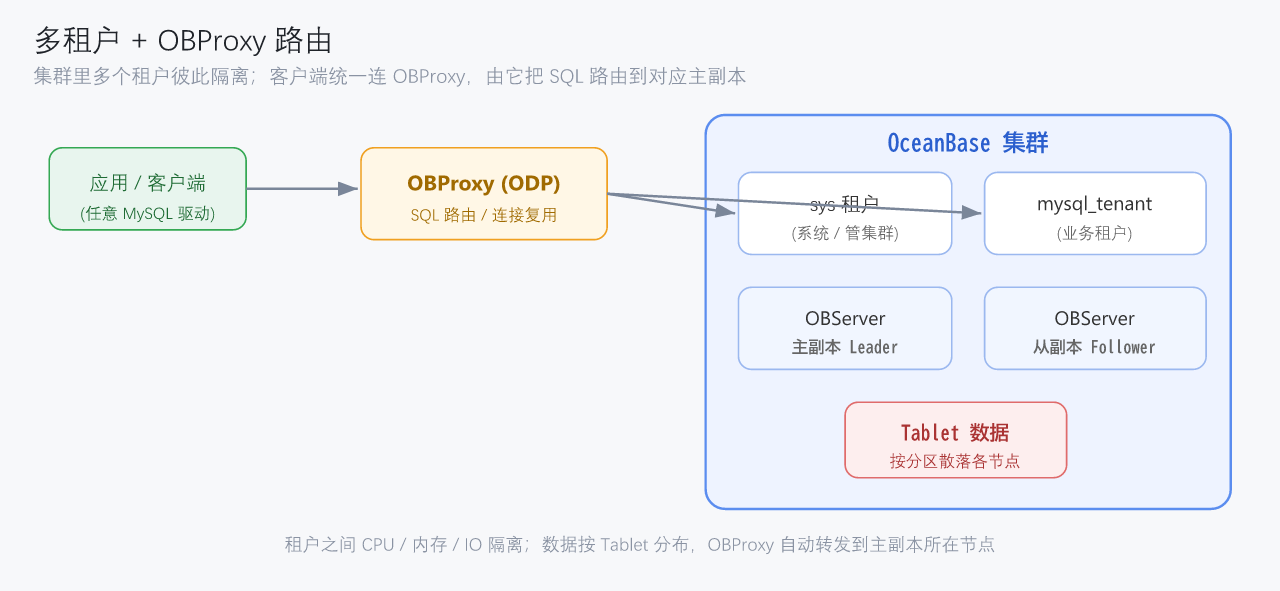
集群里多个租户彼此隔离;应用只连 OBProxy,由它把 SQL 路由到对应主副本。
2. 动手:建一个 MySQL 租户
下面以本地单机(MINI_MODE)为例。开头先确认你环境里的 zone 名和资源占用,别照抄我的 zone1:
SHOW ZONES;
-- 或者看更细的信息
SELECT * FROM oceanbase.DBA_OB_ZONES;
SELECT * FROM oceanbase.DBA_OB_UNITS;
第一步,定义一个 Unit 规格(MINI_MODE 内存有限,给小一点):
CREATE RESOURCE UNIT unit_s1
  MAX_CPU 1,
  MEMORY_SIZE '1G',
  MAX_IOPS 1000,
  MIN_IOPS 1000,
  LOG_DISK_SIZE '2G';
第二步,用这个 Unit 建一个 Resource Pool,指定落在哪个 zone:
CREATE RESOURCE POOL pool_mysql
  UNIT='unit_s1',
  UNIT_NUM=1,
ZONE_LIST=('zone1'); -- 换成你 SHOW ZONES 看到的实际 zone 名第三步,建租户,把池挂上,并声明兼容模式、可访问的 IP:
CREATE TENANT mysql_tenant
  RESOURCE_POOL_LIST=('pool_mysql'),
  PRIMARY_ZONE='zone1',
  LOCALITY='F@zone1'
  SET OB_COMPATIBILITY_MODE='MYSQL',
      OB_TCP_INVITED_NODES='%';
PRIMARY_ZONE 和 LOCALITY 后面讲高可用那篇会展开,这里先照着 zone 名填。OB_TCP_INVITED_NODES='%' 是放开连接白名单——不配这个,外部客户端连不进来,这是我的第二个坑。
建好之后,用租户身份连进去(user@tenant 这种写法):
obclient -h127.0.0.1 -P2881 -uroot@mysql_tenant -A初始 root 没密码,记得改。然后就能像普通 MySQL 一样建库建表写数据了。
CREATE DATABASE shop;
USE shop;
CREATE TABLE item (id BIGINT PRIMARY KEY, name VARCHAR(64));
INSERT INTO item VALUES (1, 'keyboard');
3. 客户端怎么连:直连 vs OBProxy
单机体验时直接连 observer 的 2881 端口最省事。但到了生产,应该在前面架 OBProxy(也叫 ODP,OceanBase Database Proxy)。
OBProxy 是独立的接入层进程,兼容 MySQL 协议。它的活儿是:自动发现数据分布,把每条 SQL 路由到对应主副本所在的 OBServer;同时做连接管理、负载均衡。对应用来说,只管连 OBProxy 一个地址,完全不用关心数据到底在哪个节点。
为什么分布式下需要它?因为数据散在多台机器,你直连某一台 observer,碰到数据不在本地的 SQL,它得走”远程 / 分布式”计划去别的节点取——OBProxy 在前面帮你做路由和连接复用,省掉这些麻烦。
本地想试 OBProxy 的话,社区版有现成镜像(具体版本和端口以你拉的为准,默认代理端口通常是 2883):
docker run -p 2883:2883 -d oceanbase/obproxy-ce
# 之后应用就连 2883,写法不变:user@tenant
obclient -h127.0.0.1 -P2883 -uroot@mysql_tenant -A
生产上 OBProxy 一般部署多个、前面再挂一层负载均衡,避免它自己成单点。
4. 分区表:数据是怎么”散”出去的
这是分布式 SQL 的入门关键。单机库里一张表基本就是一个整体;在 OB 里,表会按分区拆成多个 Tablet,每个 Tablet 才是数据分布、复制、均衡的最小单位。
分区方式常见的有 Range(按范围)、Hash(按哈希)、List、Key,还能组合。它的意义有两层:
- 水平扩展:单表再大也能拆开平摊到各 Zone 的 OBServer 上,不会卡在单机容量。
- 分区剪裁:查询能只扫相关的 Tablet,不用全表扫。
举个例子,按用户 id 哈希分 8 个区:
CREATE TABLE orders (
  id BIGINT,
  user_id BIGINT,
  amount DECIMAL(10,2),
  PRIMARY KEY(id)
) PARTITION BY HASH(user_id) PARTITIONS 8;
我当初以为”建表跟 MySQL 一样写就行”,后来才懂:分区策略直接决定数据怎么分布、热点怎么打散、查询能不能剪裁——选错了,分布式反而比单机还慢。这块值得单独花时间琢磨。
5. 小结 & 下一步
- OB 的资源模型是 Cluster → Tenant → DB → Table,中间 Unit / Pool 是资源载体;建业务租户要 Unit → Pool → Tenant 三步走。
- 连数据库生产环境走 OBProxy 更省心,应用只认一个地址。
- 分区表是数据分布的基础,分区策略直接影响性能和扩展能力。
下一篇讲高可用与弹性:把 Paxos 多数派、主副本、租约防脑裂讲透;再说 locality / primary_zone 怎么决定副本分布和 Leader 在哪;最后看看加节点扩容、一个 Zone 挂了到底会发生什么——这正好对应我们 K8s 上最该操心的容灾逻辑。
参考: