一分钟:用代码做一支没有旁白的知识视频
站点上那支 61 秒的片子(/video)不是我拿剪辑软件剪的,也不是套模板改的,是写的——用 React 写组件,用 numpy 写音乐,npm run render 出 mp4。整个过程没有打开过一次 PR、AE 或剪映。
这篇把这个过程完整摊开:装什么、怎么排时间轴、十二场怎么画、配乐怎么合成、最后怎么渲。代码都是真的,能跑。
先说清楚这条路适合什么。 适合「信息密度高、文字为主、图形为辅」的知识视频:讲解、复盘、宣传、课程片段。不适合需要真人出镜、实拍素材、复杂转场特效的片子。它的优势是可版本管理——改一个数字、重渲一次,全片都跟着变;它的短板是每个镜头都要自己写,没有现成素材库。
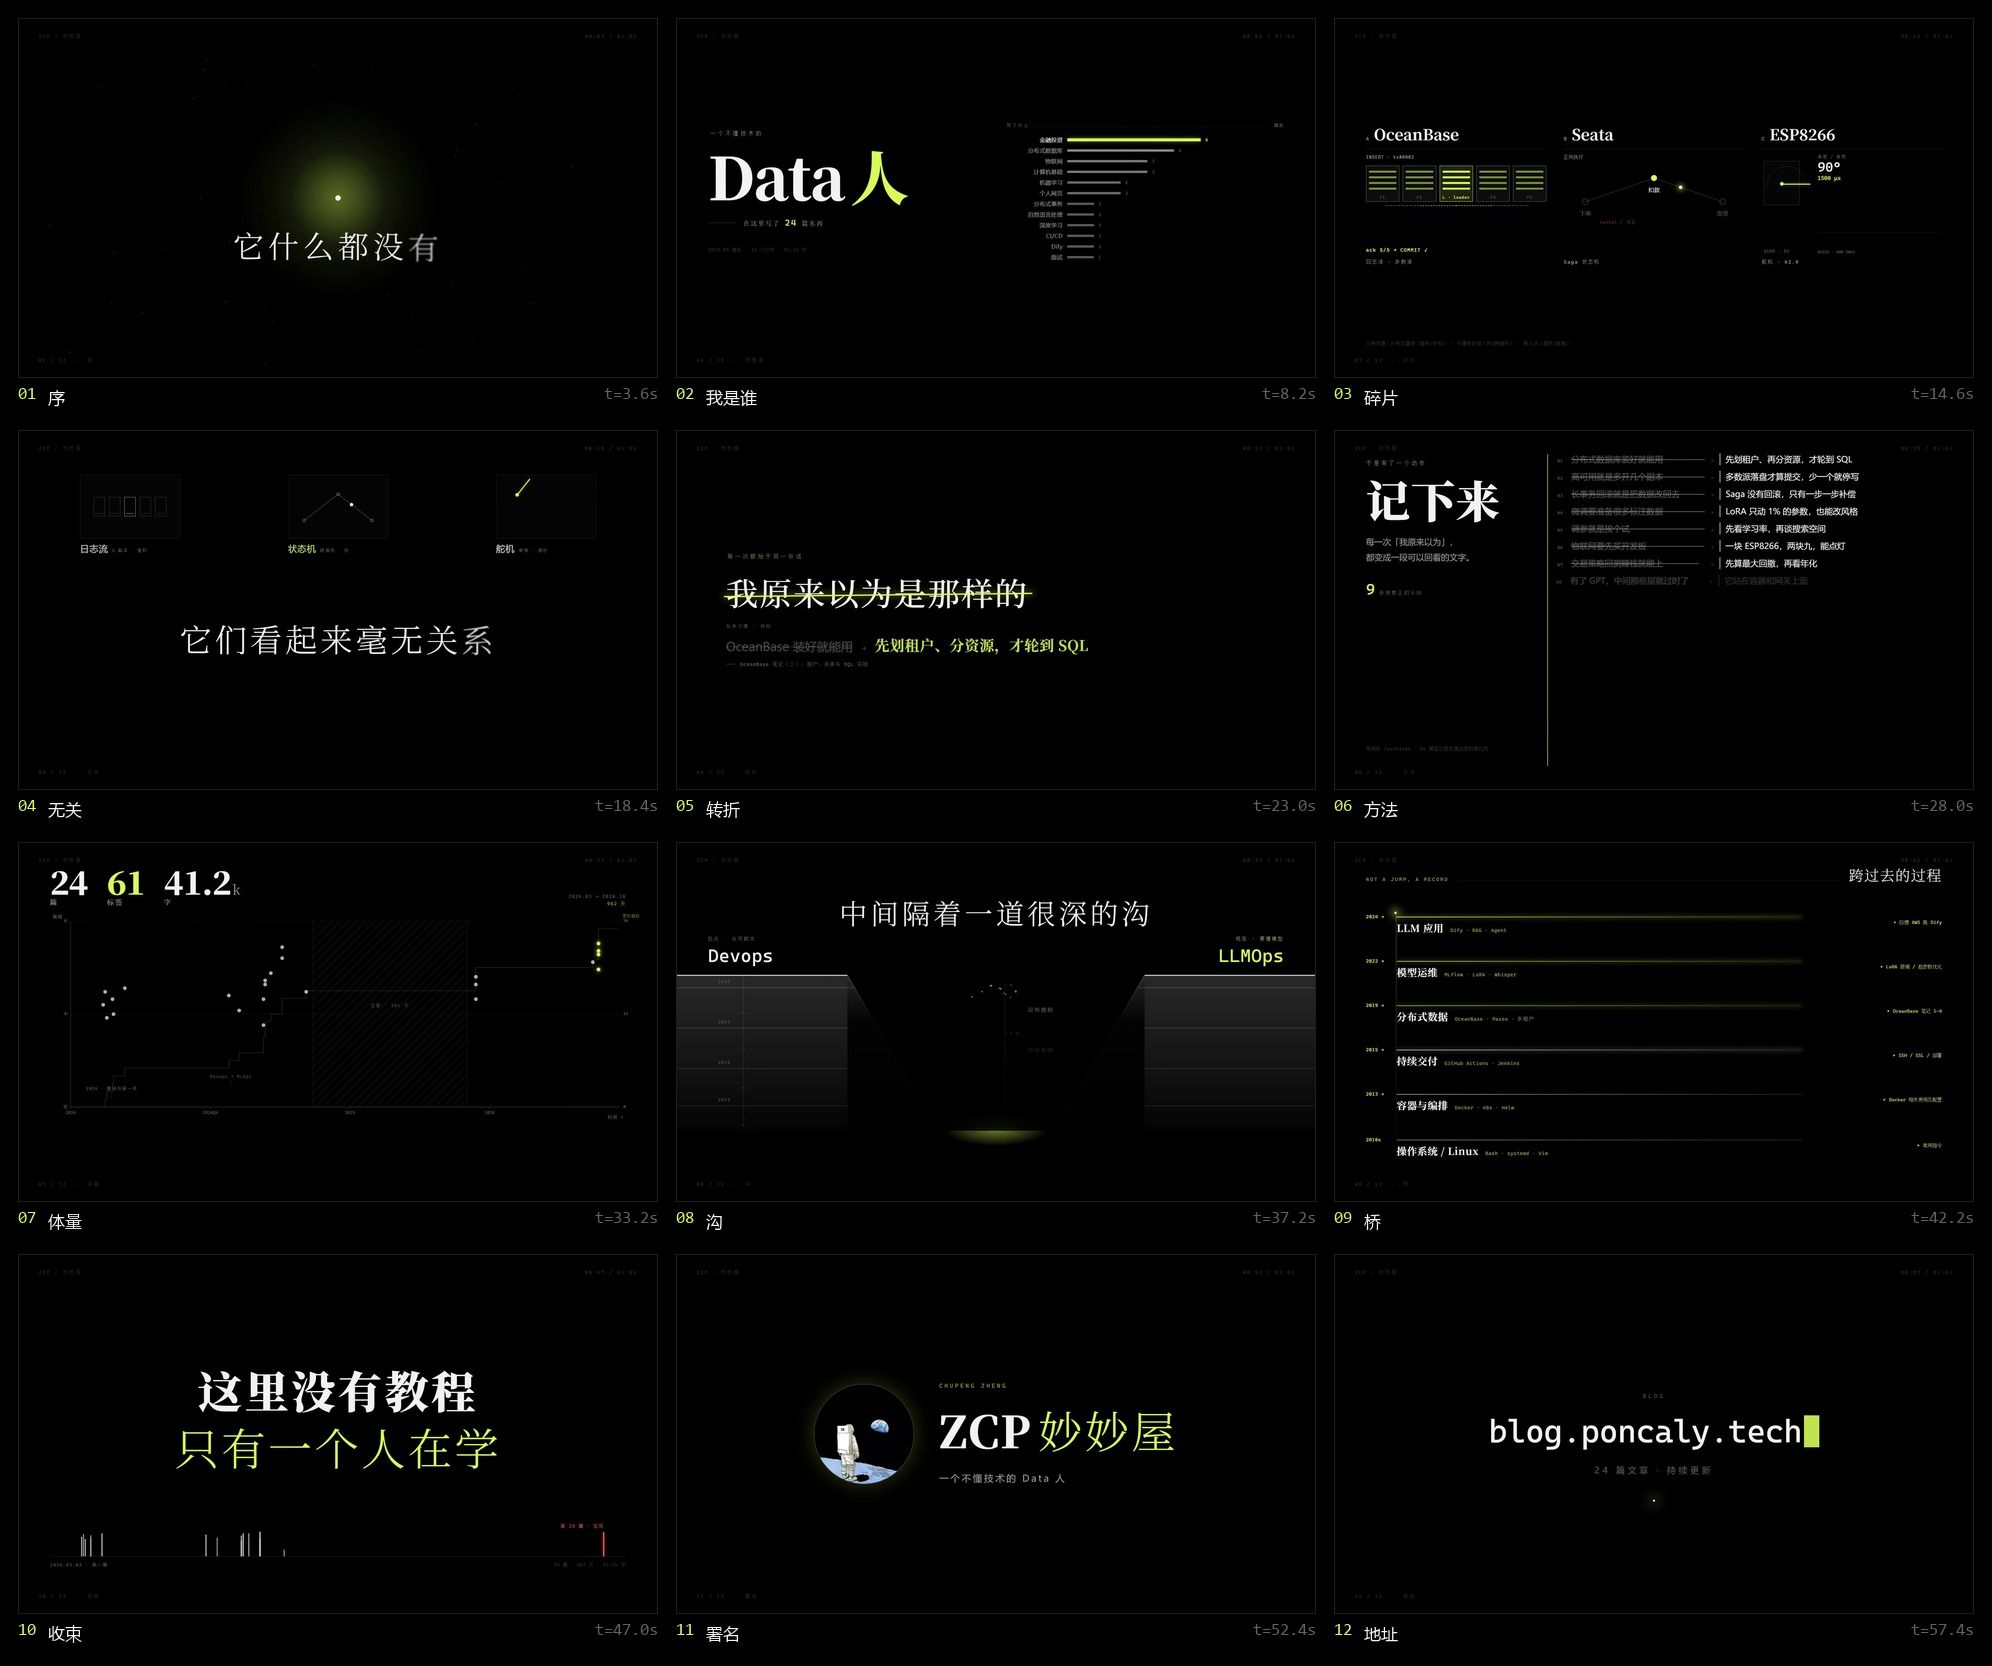
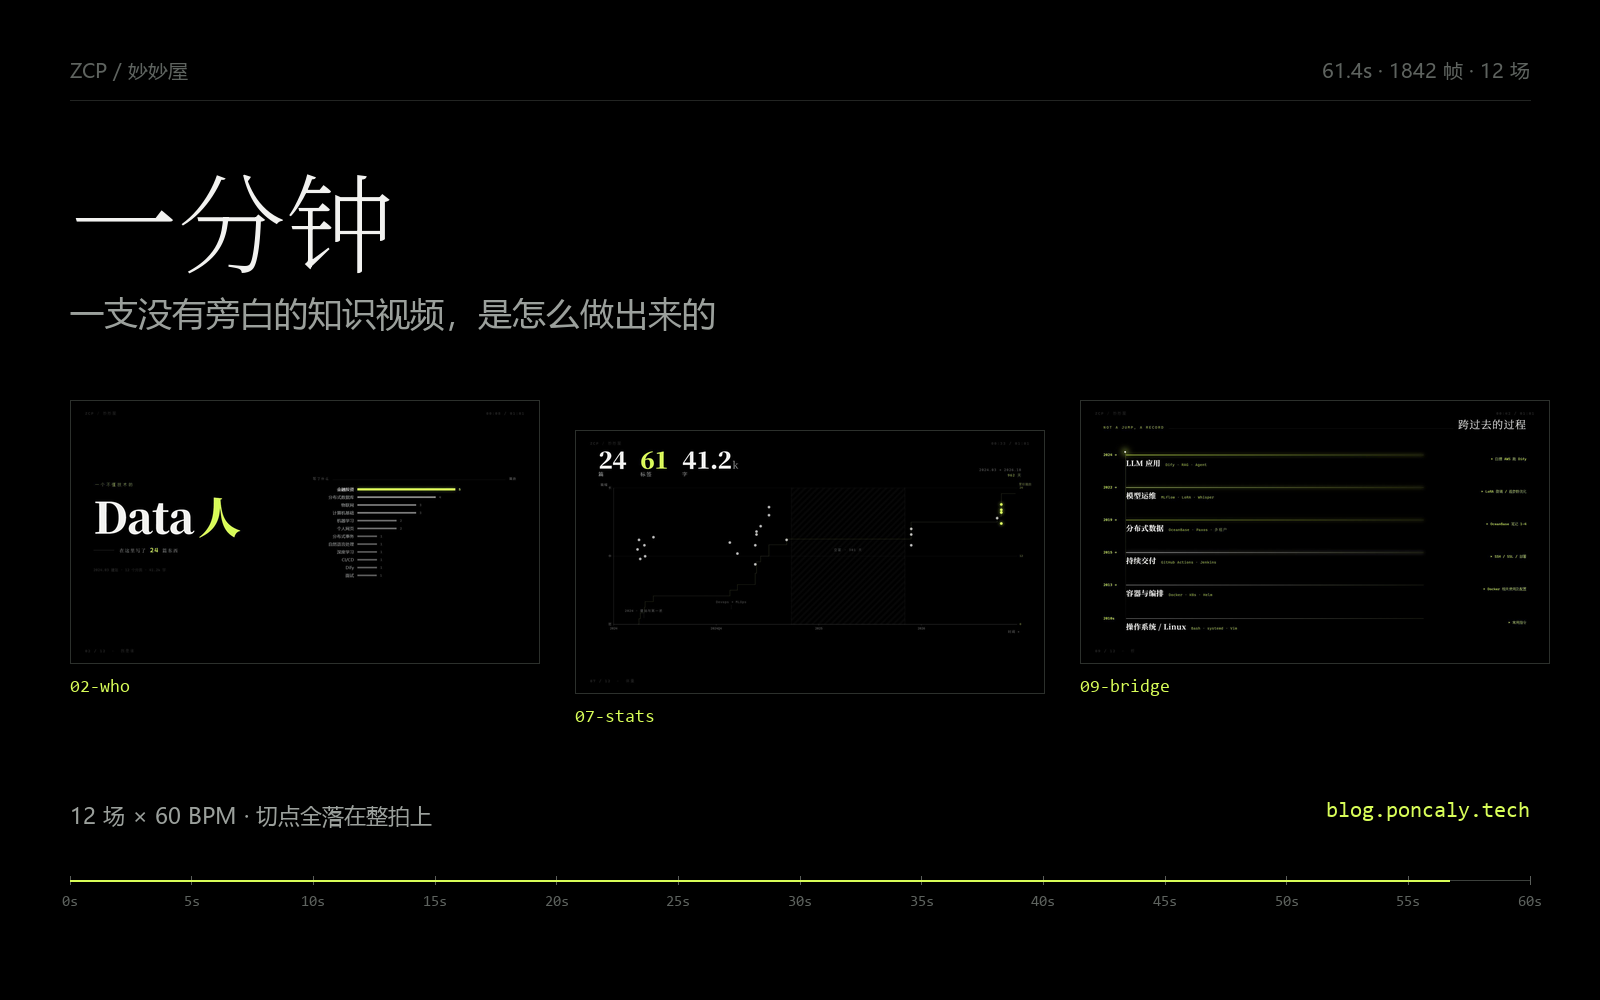
十二场,一场一个 tsx 文件。上面这张是我用 ffmpeg 抽帧拼的,检查「每屏到底有没有东西」用的。
1. 为什么不用剪辑软件
先说动机,不然你会觉得这条路是自找麻烦。
一支一分钟的片子,用剪辑软件做,大概要三四个小时:对着稿子录音、卡点、找素材图、调色、对齐。改一版再来一遍。改到第五版的时候,你已经不记得第三版为什么那样做了。
用代码做,第一次会慢——要搭环境、写组件。但从第二支片子开始,成本是断崖式下降的:
- 稿子改了?改
script.json里一句话,重排时间轴,重渲。三分钟。 - 某屏太空?打开那个
tsx文件加一张图,只渲那一帧看效果(remotion still),不用整片重渲。 - 想换配色?改
theme.ts里八个色值,全片统一生效。 - 想出一个竖屏版?改两个数字。
而且它天然可回溯——每一次改动都在 git 里,配着截图。
这套做法在圈子里有个名字叫 vibe coding:你跟 AI 说「第三屏太空了,加一张带坐标轴的真实发布时间线」,它去改代码,你在浏览器里看到结果。你负责审美和判断,它负责打字。 这支片子的 3600 行 tsx 就是这么写出来的。
2. 装什么
只有三样东西,都是免费的。
第一步:Node.js
node -v # v20 以上都行,我用的是 v23第二步:ffmpeg
Remotion 渲染时要用它编码。Windows 上从 gyan.dev 下 essentials 包,解压后把 bin 目录加进 PATH。
ffmpeg -version # 看到版本号就行第三步:一个 Chromium 内核的浏览器
Remotion 的原理是用浏览器逐帧截图,所以要一个 Chromium。它会自己去下 chrome-headless-shell,但国内经常下不动(我卡在这里半小时)。如果你机器上本来就有 Chrome 或者 Edge,直接指定给它就行:
// remotion.config.ts
import { Config } from "@remotion/cli/config";

Config.setVideoImageFormat("jpeg");
Config.setOverwriteOutput(true);
Config.setConcurrency(4);

// 本机没有 Chrome,用系统自带的 Edge(Chromium 内核)当渲染引擎。
Config.setBrowserExecutable(
  "C:\\Program Files (x86)\\Microsoft\\Edge\\Application\\msedge.exe",
);
⚠️ 避坑指南: 这一行是 Windows 用户最省事的一步。不指定的话 Remotion 会去 Google 的服务器下 headless shell,几百兆,国内基本失败。Windows 10/11 一定自带 Edge,路径就是上面这个,直接抄。
第四步(可选):Python 的三件套
配乐是 Python 合成的,需要 numpy 和 scipy:
pip install numpy scipy3. 建项目
npm create video@latest blog-promo
cd blog-promo
npm i
四个依赖,都是 Remotion 官方的:
{
  "dependencies": {
    "@remotion/cli": "^4.0.539",
    "react": "^19.3.0",
    "react-dom": "^19.3.0",
    "remotion": "^4.0.539"
  },
  "devDependencies": {
    "typescript": "^7.0.2"
  }
}
目录结构大概长这样:
script.json              12 场的最短时长与留白
tools/build-timing.mjs   排时间轴 → src/timing.json
tools/make-score.py      合成配乐 → public/score.wav
tools/check-score.py     检查配乐:响度/频段/律动/立体声宽度
tools/shots.mjs          批量抽帧(改画面时用,别整片重渲)
src/timing.json          【自动生成】每场 from/to
src/theme.ts             配色、字体、缓动、稳定伪随机
src/components/          逐字浮现、细线、等宽标签、颗粒底、HUD
src/film/BlogPromo.tsx   串场:退场→进场、配乐挂载、HUD 进度
src/film/scenes/*.tsx    12 场,一场一个文件
public/score.mp3         配乐(最终版)
关键设计:时间轴和画面是分开的。 script.json 只声明「这一场要讲什么、最短几秒、后面留多少白」,画面完全不关心自己从第几秒开始——它拿到的是 frame、start、end 三个数,自己算本地进度。这样改了顺序或者时长,画面代码一行都不用动。
4. 先把话说清楚:script.json
十二场,先写文案,不写代码。
[
  {
    "id": "01-open",
    "sub": "它什么都没有",
    "note": "空屏,一点光",
    "min": 3.2,
    "gap": 0.35
  },
  {
    "id": "02-who",
    "sub": "一个不懂技术的\nData 人\n在这里写了二十四篇东西",
    "note": "自我介绍",
    "min": 4.4,
    "gap": 0.3
  },
  {
    "id": "03-fragments",
    "sub": "OceanBase 的日志流\nSeata 的状态机\n一块两块九的舵机",
    "note": "碎片",
    "min": 5.4,
    "gap": 0.3
  }
]四个字段:id 对应文件名,sub 是这一场要说的意思(不是逐字字幕),min 是最短停留秒数,gap 是这一场结束后留多少白。
整片的结构是:空 → 我是谁 → 我在写什么 → 它们看起来毫无关系 → 但我原以为不是这样 → 我记下来 → 写了多少 → 中间隔着一道沟 → 跨过去的过程都留在这里 → 这里没有教程 → 署名 → 地址。后五场其实是一个情绪落点,前面七场都在铺。
5. 时间轴:全部对齐到 60 BPM
这是整支片子最重要的一个技术决定。
配乐是 60 BPM——1 拍正好 1 秒。所以每场的时长向上取整到整秒,间隙也取整到整秒,那么所有切点自动落在拍点上,音乐和画面永远对得上,不需要手调。
// tools/build-timing.mjs
const FPS = 30;
const BEAT = 1.0; // 秒
const BAR = BEAT * 4;

const scenes = [];
let t = 0;
for (const s of script) {
  const raw = s.min ?? 4;
  const beats = Math.max(1, Math.ceil(raw / BEAT));  // 向上取整到整拍
  const dur = beats * BEAT;
  scenes.push({ id: s.id, startSec: round(t), endSec: round(t + dur), beats });
  // 关键:间隙也必须按拍对齐,否则切点会一拍一拍地漂移
  const gapBeats = Math.round((s.gap ?? 0) / BEAT);
  t += dur + gapBeats * BEAT;
}

// 首尾留白:开头 1 秒黑场,结尾 2.4 秒余韵
const LEAD = 1.0;
const TAIL = 2.4;
⚠️ 避坑指南: 间隙一定要按拍对齐。我第一版只把场景时长取了整,间隙写成
0.35 秒这种小数,结果每场都多漂 0.35 秒——到第八场的时候,画面切了但鼓点还没到,差半拍,怎么看怎么别扭。所有时间量都必须是 1 秒的整数倍。
输出是一份 timing.json,长这样:
{
  "fps": 30,
  "width": 1920,
  "height": 1080,
  "bpm": 60,
  "totalSeconds": 61.4,
  "totalFrames": 1842,
  "scenes": [
    { "id": "01-open", "startSec": 1, "endSec": 5, "from": 30, "to": 150 },
    { "id": "02-who",  "startSec": 5, "endSec": 10, "from": 150, "to": 300 }
  ]
}
from / to 是帧号,场景组件直接用。
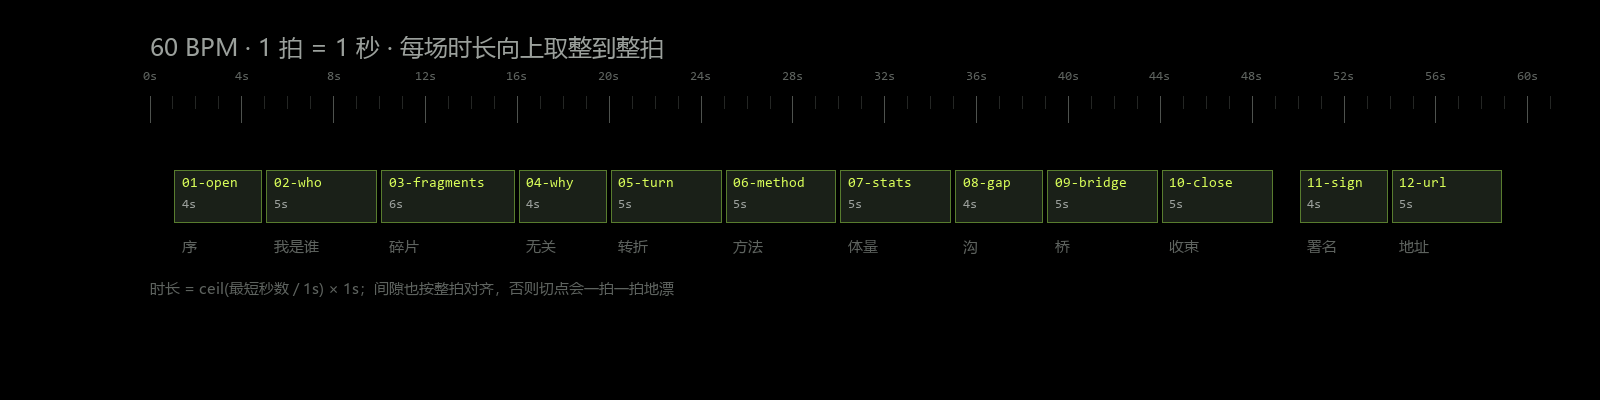
每场的时长向上取整到整秒,间隙也是。61.4 秒 = 1842 帧。底下那道蓝线是拍点。
6. 串场:先退场,再进场
这是最容易翻车的地方,单独拿出来说。
我第一版用的是交叉叠化——旧场景淡出、新场景同时淡入。看起来很自然对吧?结果是灾难:这支片子每屏都是居中大字,所以叠的那几帧里,「Data 人」和「OceanBase」两行大字重叠在一起,糊成一团黑块。
改成先退场、再进场:旧场在切点前 7 帧退干净,新场在切点后 7 帧进,中间留 1 帧近乎全黑的缝(1/30 秒)。肉眼读作硬切,但绝不会糊。
// src/film/BlogPromo.tsx
scenes.map((s, i) => {
  const next = scenes[i + 1];
  const cut = next ? next.from : timing.totalFrames;

  const OUT = 7;   // 退场 7 帧
  const IN = 7;    // 进场 7 帧

  if (frame < s.from || frame >= cut + IN) return null;

  const enter = interpolate(frame, [s.from, s.from + IN], [0, 1], CLAMP);
  const out = next
    ? interpolate(frame, [cut - OUT, cut], [0, 1], CLAMP)
    : 0;

  const opacity = enter * (1 - out);
  if (opacity <= 0.001) return null;

  // 进场从 0.988 推到 1,退场从 1 推到 1.028 —— 方向一致,像镜头一路往前
  const scale = 0.988 + 0.012 * enter + 0.028 * out;
  const blur = out * 12 + (1 - enter) * 7;

  return (
    <AbsoluteFill style={{ opacity, transform: `scale(${scale})`,
                           filter: blur > 0.05 ? `blur(${blur}px)` : undefined }}>
      <Body frame={frame} start={s.from} end={s.to} />
    </AbsoluteFill>
  );
})
两个细节值得抄:
scale单向递增。进场从 0.988 到 1,退场从 1 到 1.028。整个片子镜头永远在缓慢向前推,退场是「穿过去」而不是「缩回来」。- 退场加模糊。
blur = out * 12,退场末尾最大 12px。居中的大字一边缩小一边虚化,视觉上是「离开焦点」,比单纯淡出高级得多。
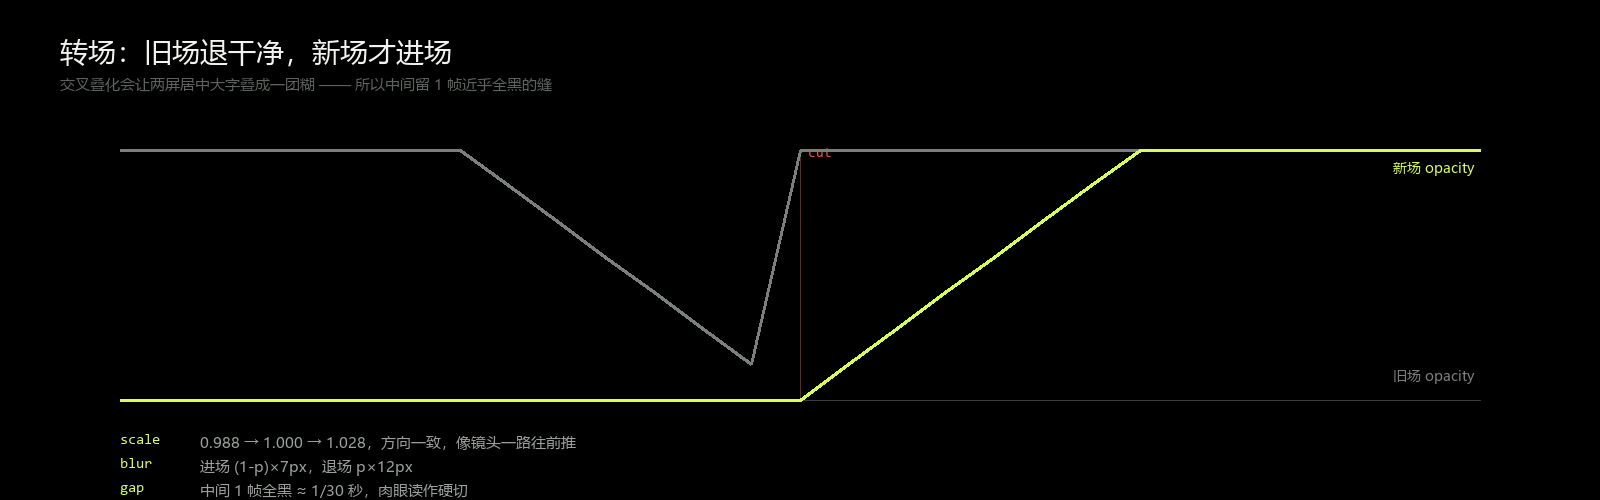
两条 opacity 曲线在切点处没有交叠区。中间那道 1 帧的缝就是「不会糊」的原因。
7. 一屏怎么画
到这里环境通了、时间轴有了、串场解决了。剩下的是最花时间的部分:十二屏,一屏一屏画。
先立一条硬规矩,这是我被骂出来的:
大字只是结论,图才是让人信的东西。
我第一版每屏只有一行大字 + 黑底。自己看着挺高级,发出去得到的评价是「太空了,没什么东西」。对照参考片才明白差距:人家的每一屏都有可以逐帧看的东西——带刻度的坐标轴、会动的状态机、几百个粒子的模拟、能数出来的数据点。
例子一:5 副本日志流
第三场「碎片」,我要表达「三种尺度」,第一种是分布式事务的毫秒级。不写「分布式事务很快」,而是画一个真的多数派提交:
// src/film/scenes/Fragments.tsx
const N = 5;          // 5 个副本
const LEADER = 2;     // 中间那个是 leader
const CYCLE = 78;     // 78 帧一轮

const l = Math.max(0, local);          // 负帧会取到负下标,会崩
const step = Math.floor(l / 12) % 6;   // 6 个阶段循环

// 每个副本的落盘高度:离 leader 越远位置越低
const diskAt = (i: number) => 8 + Math.abs(i - LEADER) * 11;
然后按 step 逐格点亮四条 Redo 日志,点亮几条就在 ack n/5 里数几个,到 3 条以上才出现 COMMIT ✓。观众看到的不是「多数派」这个词,是三根条亮起来、然后打勾这个过程。
同一场的另外两列,一列画 Saga 状态机的红色虚线补偿边(M 50% 16% Q 50% 72%, 12% 42%),一列画 SG90 舵机的真实角度与 PWM 脉宽:
const ang = 90 + 80 * Math.sin((l / 72) * Math.PI * 2 - Math.PI / 2);
const pulse = 500 + (ang / 180) * 2000;   // 0.5ms ~ 2.5ms
摆臂真的会转,旁边的读数是 {Math.round(ang)}° 和 {Math.round(pulse)} µs。这些数字是对的——SG90 就是 50Hz、500–2500µs。
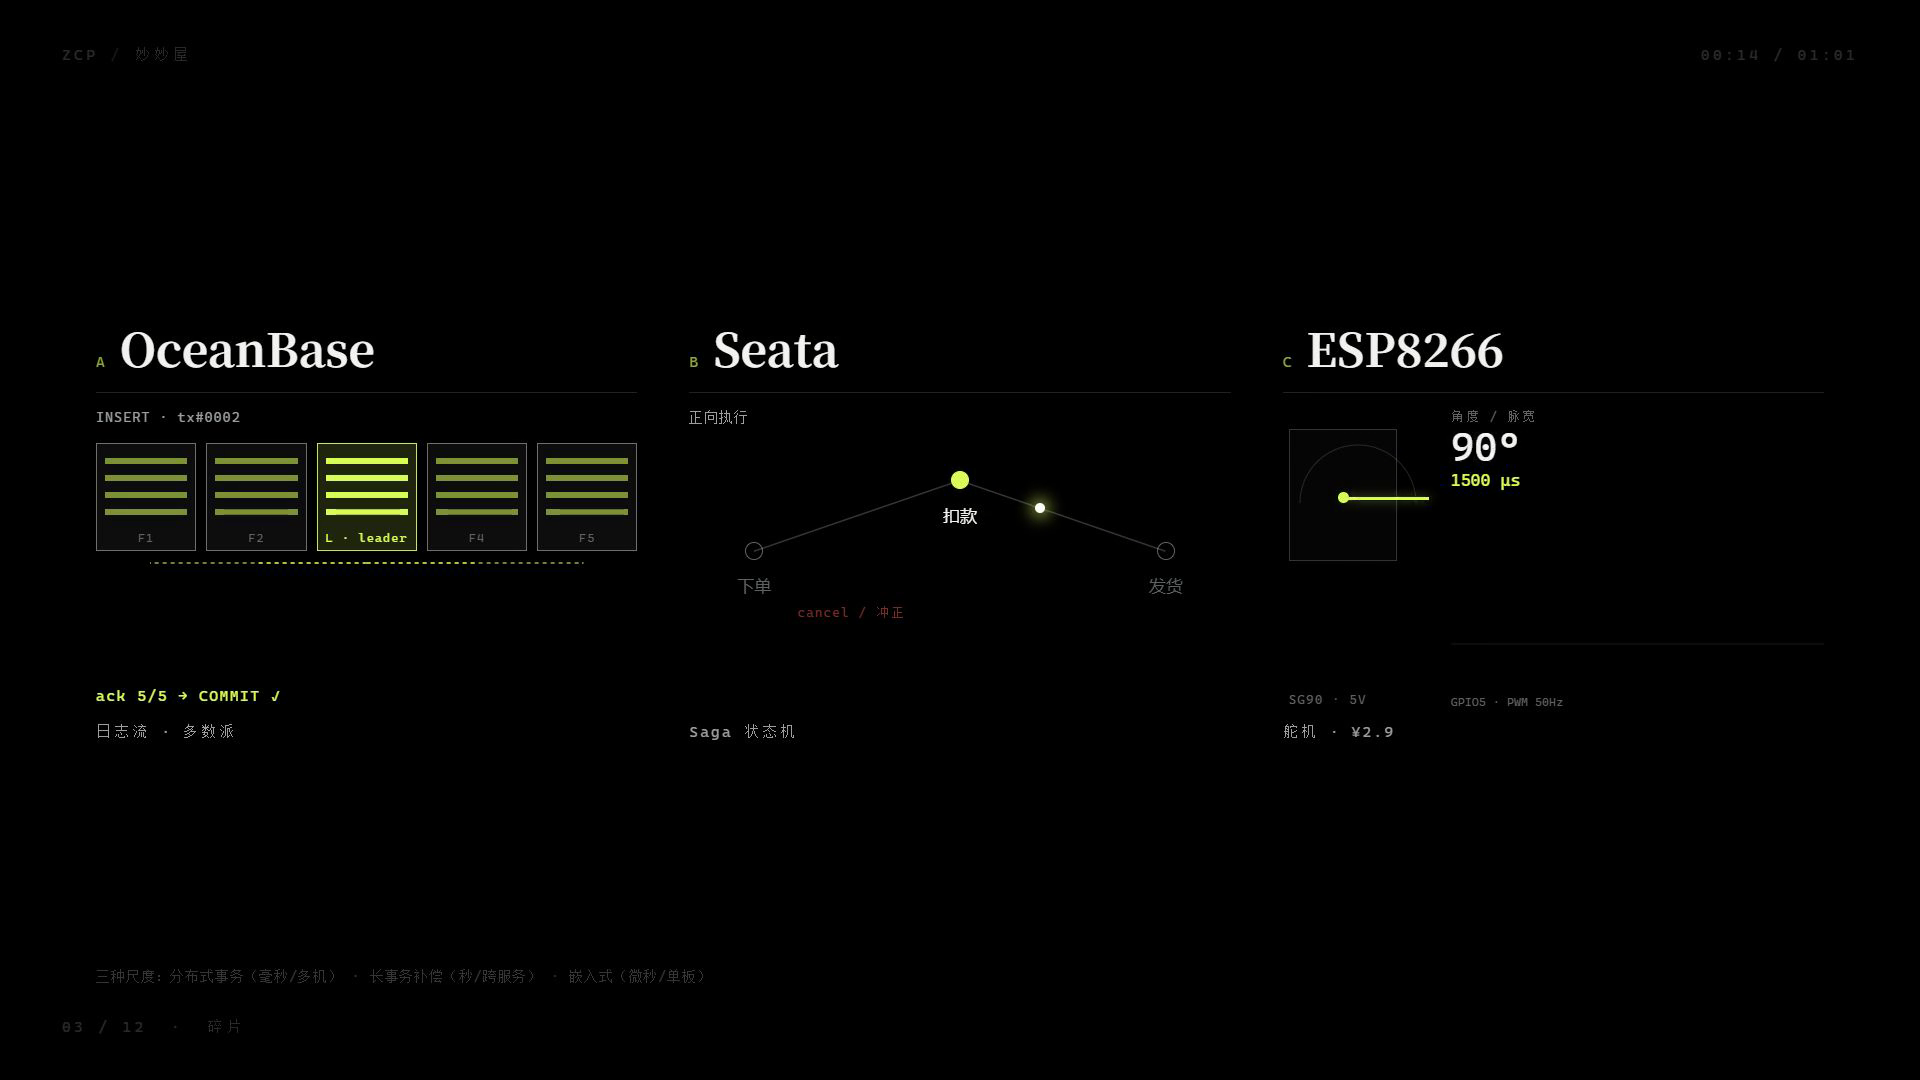
例子二:真实发布时间轴
第七场「体量」,要说「我写了 24 篇」。写一个大大的 24 毫无意义。所以我把 24 篇文章的真实发布日期做成了一张散点图:
// src/film/scenes/Stats.tsx
const POSTS = [
  { d: [2024.17, 2024.18], w: 0.55, t: "Hexo + Github 个人网页" },
  { d: [2024.19, 2024.20], w: 0.48, t: "简单 NLP 情感分析" },
  // ...
  { d: [2026.83, 2026.84], w: 0.88, t: "OceanBase 笔记 3:高可用与弹性" },
];

const X0 = 2024.0;
const X1 = 2026.95;
const norm = (y: number) => (y - X0) / (X1 - X0);
每个点是一篇文章,横坐标是发布日期,纵向高低是篇幅。然后这张图上自动浮现出三件我自己都没意识到的事:
- 中间有一大段空窗:2025 年年中到 2026 年初,将近一年没写。图上标了「空窗 · 301 天」。
- 最近七天写了五篇:最后那四个点挤在一起,密得像一条竖线。
- 累计曲线在空窗期是平的。
这就是「图」比「数字」有说服力的地方——你没法用一句「我很努力」表达出那条平掉的曲线。
💡 经验: 每一屏都问自己一句「观众能在这屏上数出什么、看出什么趋势」。如果答案是「什么都数不出来」,那这屏就是空的,加字没用,得加图。
8. 配色与字体
整套视觉只有 8 个颜色,全片统一:
// src/theme.ts
export const C = {
  bg: "#000000",     // 纯黑
  bg2: "#08090A",    // 次级黑
  ink: "#F2F2F0",    // 米白(不是纯白,纯白在纯黑上刺眼)
  inkDim: "#9BA09C", // 次级文字
  mute: "#5E635F",   // 脚注、辅助线
  lime: "#D8FD58",   // 唯一的强调色
  limeDim: "#8FA83A",// 强调色的暗版本
  red: "#F1574D",    // 只用来标「错」和「缺」
} as const;
三条规矩:
- 只有一个强调色。荧光绿。所有需要「被看见」的东西都是它,其余全是灰阶。颜色一多,强调就失效了。
- 红色只表示负面。全片红色只出现三次:一屏三个「0 分」、一条「没有教科书」、最后「下一篇永远在写」。
- 衬线做大标题,无衬线做正文,等宽做数据。这三种字体的分工要严格,混用会显得随便。
export const F = {
  serif: '"Noto Serif SC", "Songti SC", "SimSun", serif',
  sans:  '"Microsoft YaHei UI", "Microsoft YaHei", "Noto Sans SC", sans-serif',
  mono:  '"Cascadia Mono", "Consolas", ui-monospace, monospace',
};
背景不是纯黑——叠了一层 SVG 颗粒(feTurbulence,opacity 0.055)和径向暗角。纯黑在多数屏幕上会显得「死」,加一点点噪点立刻有质感,而且几乎不增加编码体积。
// src/components/Backdrop.tsx
<svg>
  <filter id="grain">
    <feTurbulence baseFrequency="0.82" numOctaves="3" />
  </filter>
  <rect width="100%" height="100%" filter="url(#grain)"
        opacity={0.055} style={{ mixBlendMode: "overlay" }} />
</svg>
9. 动效:三个函数就够了
全片 3600 行代码,动效其实只靠三个函数。
// 把帧号映射到 0→1 的进度,超范围自动夹紧
export const prog = (frame: number, start: number, dur: number) =>
  Math.min(1, Math.max(0, (frame - start) / dur));

// 0→1,前快后慢。所有「炸开」的进场都用它
export const easeOutExpo = (t: number) => (t >= 1 ? 1 : 1 - Math.pow(2, -10 * t));

// 稳定伪随机。Remotion 是并发多线程渲染的,Math.random() 会导致同一帧
// 在不同 worker 上算出不同的值,画面闪烁。必须用确定性哈希。
export const rnd = (n: number): number => {
  const x = Math.sin(n * 127.1 + 311.7) * 43758.5453;
  return x - Math.floor(x);
};
⚠️ 避坑指南:粒子、星尘、随机抖动——全部不能用
Math.random()。 Remotion 会把 1842 帧分给 8 个进程同时渲染,每个进程里Math.random()的种子不同。结果就是同一颗星星在第 100 帧和第 101 帧跳到完全不同的位置,成片满屏闪烁。用rnd(i)这种基于下标的哈希,同一个i永远得到同一个数。
用法很直接。比如开场 140 颗星尘,全部在 useMemo 里一次性生成:
const stars = React.useMemo(
  () => Array.from({ length: 140 }, (_, i) => ({
    a: rnd(i * 3.1) * Math.PI * 2,          // 角度
    d: 0.25 + rnd(i * 7.7) * 0.75,          // 距离系数
    delay: rnd(i * 5.5) * 34,               // 延迟(帧)
    drift: 0.85 + rnd(i * 13.9) * 0.5,      // 漂移速度
  })),
  [],
);
然后是逐字浮现——每个字带上浮 + 模糊:
const p = easeOutExpo(prog(frame, start + i * stagger, 16));
<span style={{
  opacity: p,
  transform: `translateY(${(1 - p) * 0.22}em)`,
  filter: p < 0.995 ? `blur(${(1 - p) * 12}px)` : undefined,
}}>{ch}</span>
stagger 默认 1.4 帧——也就是每个字比前一个字晚 1.4 帧出现。一秒钟能出 21 个字,读起来像有人在打字,但不像打字机那么机械。
10. 配乐:用 numpy 合成八层
这是整件事里最”不讲理”的部分。片子里没有旁白,音乐是唯一的情绪线索,所以它不能是随便找的 BGM——必须跟着画面走。
先测参考片。我扒了 B 站《涌现·参数的史诗》的音轨,做频谱分析:
| 指标 | 参考片实测 |
|---|---|
| 速度 | 60 BPM(自相关峰 0.636) |
| 20–120Hz 占比 | 57.6% |
| 120–400Hz | 21.3% |
| 400Hz–2kHz | 13.6% |
| 2k–8kHz | 7.5% |
| 低频敲击间隔 | 0.75–1.75 秒(稀疏,不是四四拍) |
结论很清楚:超低频占一半以上,中高频很少,鼓点很稀。这不是流行歌,是氛围音乐。
那就不采样、不联网,纯合成。八个层:
| 层 | 作用 | 声音 |
|---|---|---|
| PAD | 和弦铺底 | Dm–Bb–F–C 循环,每和弦 8 秒 |
| SUB | 超低频 drone | 根音下沉一个八度,单声道 |
| ARP | 中频琶音,全片真正的旋律 | 和弦内音 +2 八度,每拍一个 |
| SHIMMER | 高频泛音 | 三/五度 +2 八度,慢颤音 |
| BELL | 高频闪烁点 | 每 2 拍一个,左右交替 |
| PULSE | 稀疏低频敲击 | 每 2 拍一次音高下滑的「心跳」 |
| NOISE | 空气层 + 转场 riser | 切点前 1.6 秒噪声带通上扫 |
| IMPACT | 段落重音 | 5 个关键场景砸一下 |
关键机制是 LAYERS 配器表——每个场景一行,控制该段各层的增益:
# tools/make-score.py
LAYERS = {
    "01-open":  dict(pad=0.35, sub=0.55, arp=0.00, shim=0.00, pulse=0.10),
    "04-why":   dict(pad=0.70, sub=0.80, arp=0.10, shim=0.15, pulse=0.00),
    "05-turn":  dict(pad=1.00, sub=1.00, arp=0.45, shim=0.22, pulse=0.04),
    # ...
}
于是「它们看起来毫无关系」那一段,pulse 关掉、noise 加大,画面和音乐一起留白;「我原来以为是那样的」那一段,所有层拉满。段内前 55% 保持、后 45% 过渡,所以变化只发生在切点附近,不会中途突然变响。
合成完还要做一遍后处理,顺序不能反:
x = np.tanh(x * 1.30) / 1.30        # 软饱和,压掉峰值
x = highpass(x, 2600, gain=0.85)    # 提亮高频
x = highpass(x, 55) - lowpass(x, 130) * 0.22   # 收低频
x = fade_in(x, 2.2) * fade_out(x, 3.4)        # 头尾淡入淡出
x = x / np.abs(x).max() * 0.891     # 峰值归一
最后过一遍 ffmpeg 的响度标准化,这一步必做:
ffmpeg -y -i public/score.wav \
  -af "loudnorm=I=-12:TP=-0.8:LRA=9" \
  -c:a libmp3lame -b:a 256k public/score.mp3
I=-12 是目标响度,TP=-0.8 是峰值上限。出来实测 -11.7 LUFS / true peak -0.6 dBTP,和主流流媒体平台一致——不会有人把音量拧到 100 还听不清,也不会炸。
⚠️ 避坑指南:不要自己写压缩器。 我一开始想用一阶 IIR 估算包络做动态压缩,写了两百行,结果 RMS 反而从 -14 掉到 -17.5dB——包络估不准,增益一直在抖。直接交给 ffmpeg 的
loudnorm,一行顶两百行。
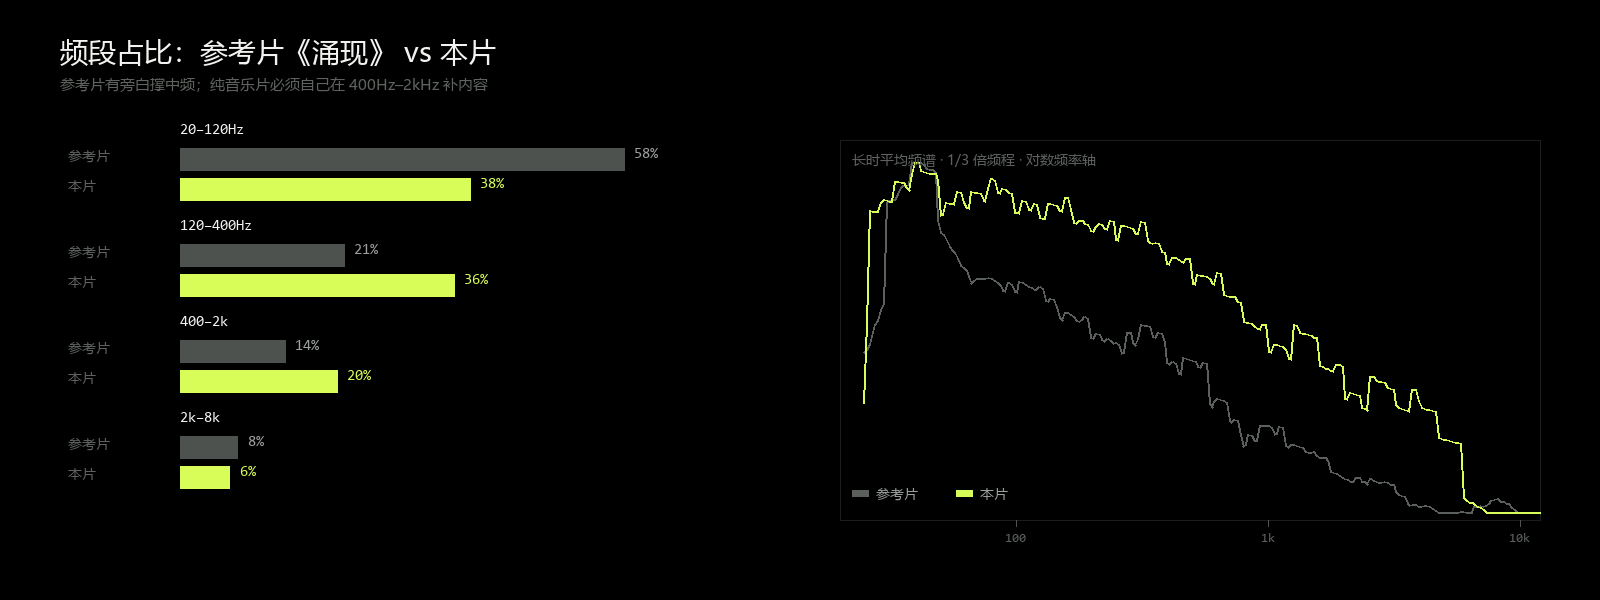
左边四个频段的占比对照(参考片 vs 我这支),右边是长时平均频谱。我这版中低频更足——因为参考片有旁白撑中频,纯音乐的片子必须在 400Hz–2kHz 有内容,否则听起来像「嗡」而不像「曲子」。
11. 千万不要整片重渲
这一步能省你 80% 的等待时间。
整片 1842 帧、1080p30,渲一次三分钟。改一屏看效果就等三分钟,一天下来你会疯。所以做一个抽帧脚本:
// tools/shots.mjs
for (const f of frames) {
  const out = path.join(OUT, `f${String(f).padStart(5, "0")}.jpg`);
  if (!fs.existsSync(out)) {                    // 已存在就跳过
    execFileSync("npx", [
      "remotion", "still", "BlogPromo", out,
      `--frame=${f}`, "--image-format=jpeg", "--jpeg-quality=92",
    ], { cwd: ROOT, stdio: "inherit", shell: true });
  }
}
node tools/shots.mjs --scene 会给每一场取中点抽一帧,十二张图,二十秒出完。改了一屏,看一眼就够。
⚠️ 避坑指南:那个
existsSync跳过逻辑会坑你。 改了场景之后如果忘了删旧图,脚本会直接返回上一次的截图,你会盯着旧图找半天 bug。改完先Remove-Item out/check/*.jpg。
12. 出片
# 主版:母版质量
npx remotion render BlogPromo out/BlogPromo.mp4 --concurrency=8

# 网页版:CRF 26,给博客用
npx remotion render BlogPromo out/BlogPromo-web.mp4 --crf=26 --concurrency=8
同一条片子,两种码率:
| 主版 | 网页版 | |
|---|---|---|
| 体积 | 5.7 MB | 4.1 MB |
| 参数 | 默认 CRF 18 | --crf=26 |
| 用途 | 存档、投稿 | 站内嵌入 |
--concurrency=8 的意思是用 8 个进程并行渲。你的核多就往上加,我的机器(Ultra 9 + 5080)开 8 是甜的,开到 16 反而因为上下文切换变慢。
13. 踩过的坑,一次说完
1. 交叉叠化会让居中大字糊成一团。 这条已经说过,值 7 帧。
2. Math.random() 会导致满屏闪烁。 并发渲染下必须用确定性哈希。
3. 负帧会取到负下标然后崩。 场景组件拿到的 frame - start 在某些边界帧是负数,Math.floor(local / 22) 直接变成 -1,然后 arr[-1].x → Cannot read properties of undefined。加一行 Math.max(0, local) 就好。
4. 间隙不对齐拍点会让全片慢慢漂。 所有时间量必须是 1 秒整数倍。
5. 绝对定位的 div 别插进 <svg> 里。 我往 SVG 里塞了三个 <div>,它们整个不渲染,而且不报错——抽帧看半天以为是动画没触发。SVG 里只能放 SVG 元素。
6. 中文字体在 PIL 里可能是豆腐块。 用 consola.ttf 渲染中文会得到一排方框。按字符串里有没有 CJK 字符切换字体:
_cjk = re.compile(r"[\u3000-\u9fff\uff00-\uffef]")
path = F_MONO if not _cjk.search(s) else (F_SERIF if serif else F_SANS)
7. Windows 的 Smart App Control 会拦 ffmpeg。 这台机器开着 SAC,node_modules 里那个未签名的 ffmpeg.exe 写系统 TEMP 会 Permission denied。解决办法是把 TEMP 指到项目目录:
$env:TEMP="D:\DeepSeekWorkspace\.tmp"; $env:TMP=$env:TEMP8. 别指望 mermaid。 这个博客主题里 mermaid 是关的。文章里的图全是 PNG,用 PIL 手绘 + ffmpeg 抽帧。
14. 所以「vibe」到底体现在哪
不是「AI 帮你写代码」这么简单。真正的变化在迭代速度。
传统流程里,改一屏的成本是「打开软件、找到那个镜头、改、预览、导出一段」。十分钟起。
这条路上,改一屏的成本是「改一个 tsx 文件、渲一帧、看一眼」。二十秒。
成本降一个数量级,你的判断标准就会变。原本你会想「这样也行吧」,现在你会想「这屏还是空的,换掉」。因为试错变便宜了,你才敢多试。
这支片子前后大改了四版:
- v1:十二屏大字 + 配音。被评价「太空」。
- v2:去掉配音,配乐重做八层。被评价「怎么还有配音」(因为代码没删干净)。
- v3:八屏重画,加上真实图表。自己觉得可以了。
- v4:最后三屏(Who / Stats / Gap)再补数据,加累积曲线、深度刻度、962 天证据条。
每一版都是「渲出来 → 看 → 删 → 重写」。如果没有那条二十秒的反馈回路,第三版我就收工了。
15. 想看源码
整套东西在一台机器上,没有开源(里面的数据都是我自己的)。但结构就在第 3 节,你照着搭一遍,两个小时能让第一个 Hello World 动起来。
如果只是想看成品:
- 片子:一分钟
- 参考片:《涌现 · 参数的史诗》BV1vXHr6eEoN,B 站。我这支的视觉语言、节奏、配乐思路全部来自它。
- Remotion 官方文档:remotion.dev。写得非常好,这行字是真心的。
最后说一句实在话:这条路不适合所有人。 如果你一年只做一支片子,学这套的成本收不回来。但如果你是那种「每篇博客都想配个视频」的人,或者做课程、做产品介绍、做年终复盘——写一次,之后每支都是改参数。
我下一篇大概率还是会用这套做。