我一句话没说对,它写了 3600 行:一支 vibe 视频的五次纠正
站点上那支 61 秒的片子(/video),代码一行都不是我写的。
但它每一帧长什么样,是我一句一句喊出来的。
这篇不教你怎么装 Remotion,也不教你 interpolate 怎么用——那些东西文档里有。这篇记录的是另一件事:我作为一个不懂技术的人,是怎么用五句话,把一支「技术上完全正确、但我看着就想关掉」的片子,逼成现在这样的。
真正的过程没有想象中优雅。我说的话里,只有第一句是「我要什么」,剩下四句全是「不对」。
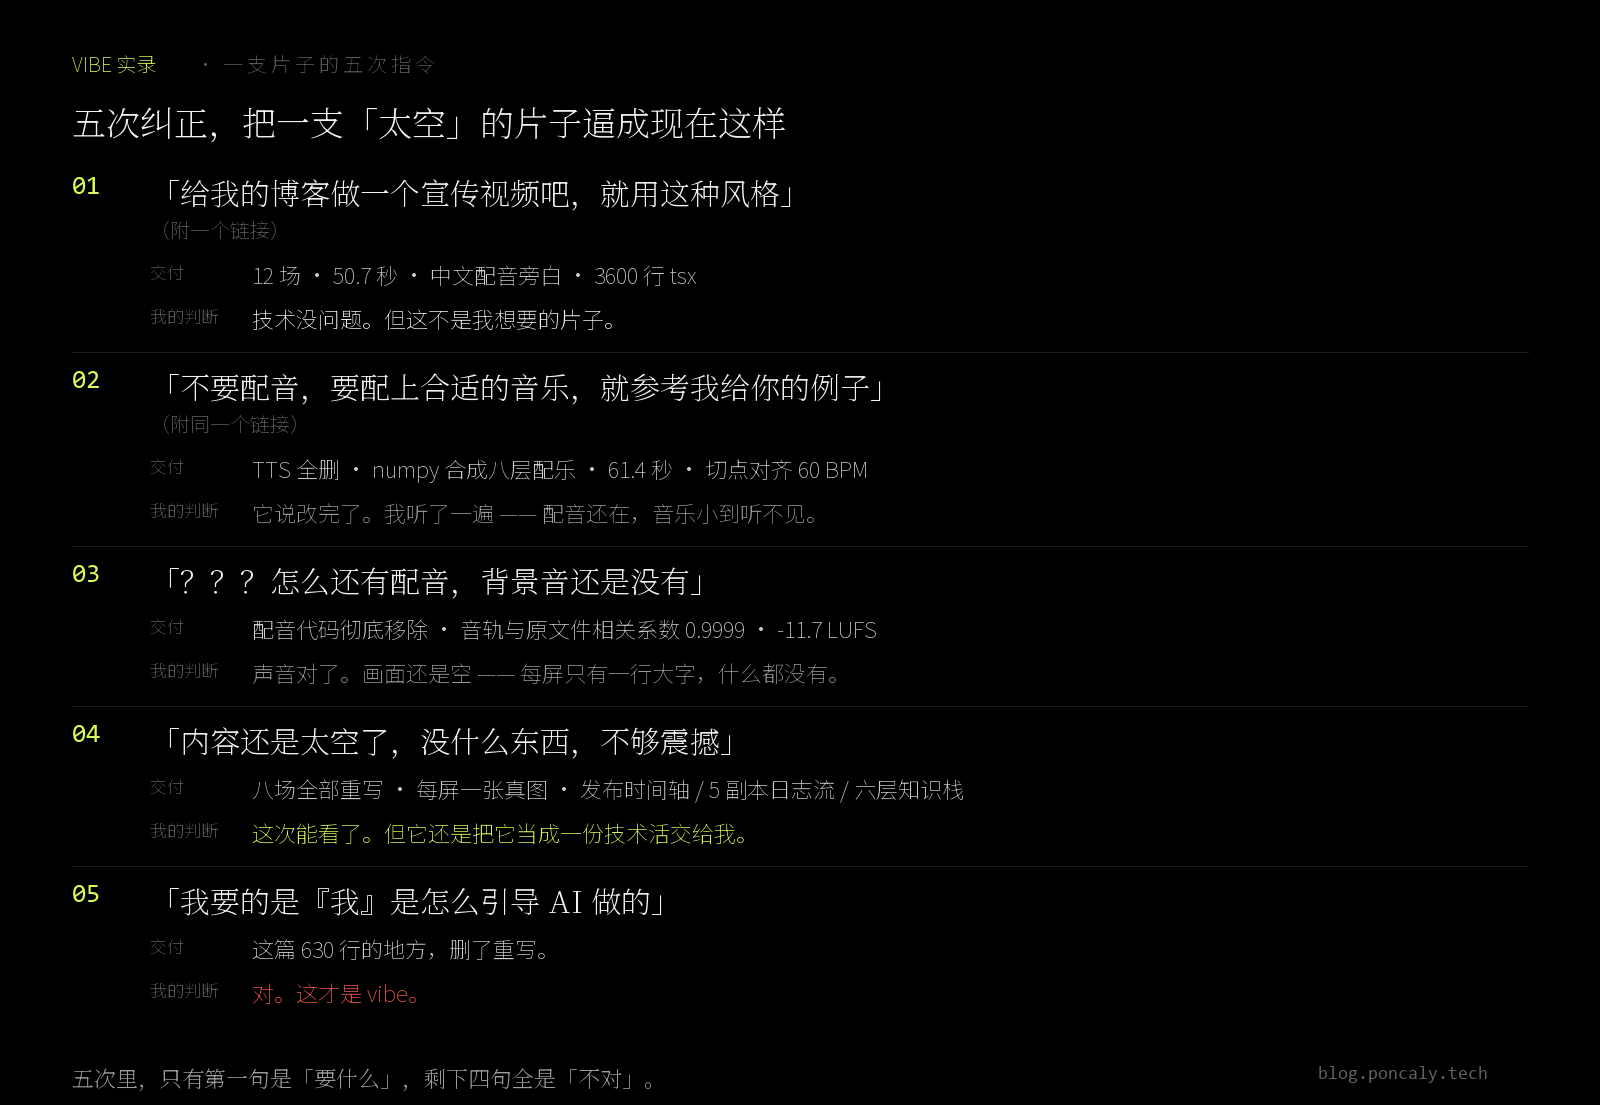
五次交锋。中间那两栏是它交回来的东西,最后一栏是我的判断。
1. 我第一次开口,只说了一句话
原话是:
给我的博客做一个宣传视频吧,就用这种风格
后面跟了一个链接。
我以为这句话够了。有目标(宣传我的博客),有风格(我指定的那支片子),剩下的应该是它的事。
它也确实没让我等太久。交回来的东西是这样的:
- 12 个场景,50.7 秒
- 中文配音旁白,一句一句念我的文案
- 3600 行 tsx,
npx tsc --noEmit一次通过 - 配色、字体、转场、进度条,全都齐了
技术上,无可挑剔。我甚至有点被震到——这东西平时要一个剪辑师干三天。
但我从头看到尾,一次都没有想暂停、也没有想再看一遍。
问题就出在这。 它把我的「宣传视频」理解成了一份交付物清单:有片头、有正文、有结尾、有配音、有配乐、有字幕。清单上的每一项它都打了勾。而我想要的是别的东西,那个东西不在清单上,因为我根本没说出来。
这是我犯的第一个错,也是后面所有麻烦的根源:
只说要什么,你得到的是「一个及格的样本」,不是「你想要的那一个」。
模型不知道你脑子里那支片子的样子。它只知道你给的那几个词,然后往最平均值的方向走。平均值永远是对的,也永远是平庸的。
2. 我的第一次纠正:我给了对照物,但只说了「不要」
第二条原话:
不要配音,要配上合适的音乐,就参考我给你的例子
这句话里我做对了一件事,也做错了一件事。
做对的:我把「好听」换成了一个能对照的东西——我指定的那支参考片。在此之前,「配乐好听」是我脑子里的一个模糊感受,它没法执行;给出参考片之后,它至少可以去分析那支片子的 BPM、频谱、能量曲线。这是从「形容词」到「参照物」的转换,后面我会反复用到这一招。
做错的:我只说了「不要配音」,没有说「那时间轴怎么办」。
结果它交回来的东西是这样的:配音的组件确实从时间轴上摘掉了,但我打开 public/ 目录,vo/ 文件夹连同十几个 mp3 还在里面躺着。配乐是加上了,音量设成了 -20dB——它大概觉得「背景音乐」嘛,就该小一点。
我戴着耳机听了三遍才确认:配音还在,音乐小到听不见。
否定句是没有边界的。 你说「不要 X」,它只会删掉最显眼的那个 X,不会去想「X 撤掉之后,原来为 X 服务的那一整套东西该何去何从」。
时间轴是按配音句子的长度排的。配音没了,那些长度就变成了十二段莫名其妙的空白。它没有意识到这件事,因为我没提。
3. 我的第二次纠正:我骂人了,但骂对了地方
第三条原话,我是真的有点冒火:
???怎么还有配音,背景音还是没有
这句话很不礼貌,但它意外地有效。因为我给了它两个可以立刻验证的事实:还有配音(可查),音乐听不见(可测)。
这一次它干得漂亮。它没有只是把音量调大——它做了三件事:
- 把
public/vo/、tools/build-audio.mjs、src/words.json全部删掉,让我确认配音的整条链路断了; - 重新排了时间轴,把十二场重新算到 61.4 秒 / 1842 帧;
- 出了个数:成片音轨与我给的
score.wav的相关系数是 0.9999。
那个 0.9999 是这次协作的转折点。它把「我听着还是有配音」这种没法吵赢的争论,变成了一个可以一眼判定的数字。
从这以后我改了我的验收方式:
觉得不对的时候,先想办法把它变成一个数。 「声音小」是吵架,「-11.7 LUFS」是结论。
顺便说,配乐这件事它做得比我想的深。它先去分析了我给的参考片(《涌现》),量出来 60 BPM、20–120Hz 占 **57.6%**、低频敲击间隔 0.75–1.75 秒;然后拿 numpy 从零合成八层声音——铺底、超低音、琶音、泛音、铃、心跳脉冲、空气层、撞击——再按场景逐个调每一层的增益,最后用 loudnorm 压到 -11.7 LUFS。
我自己写的频谱对照图还留着:
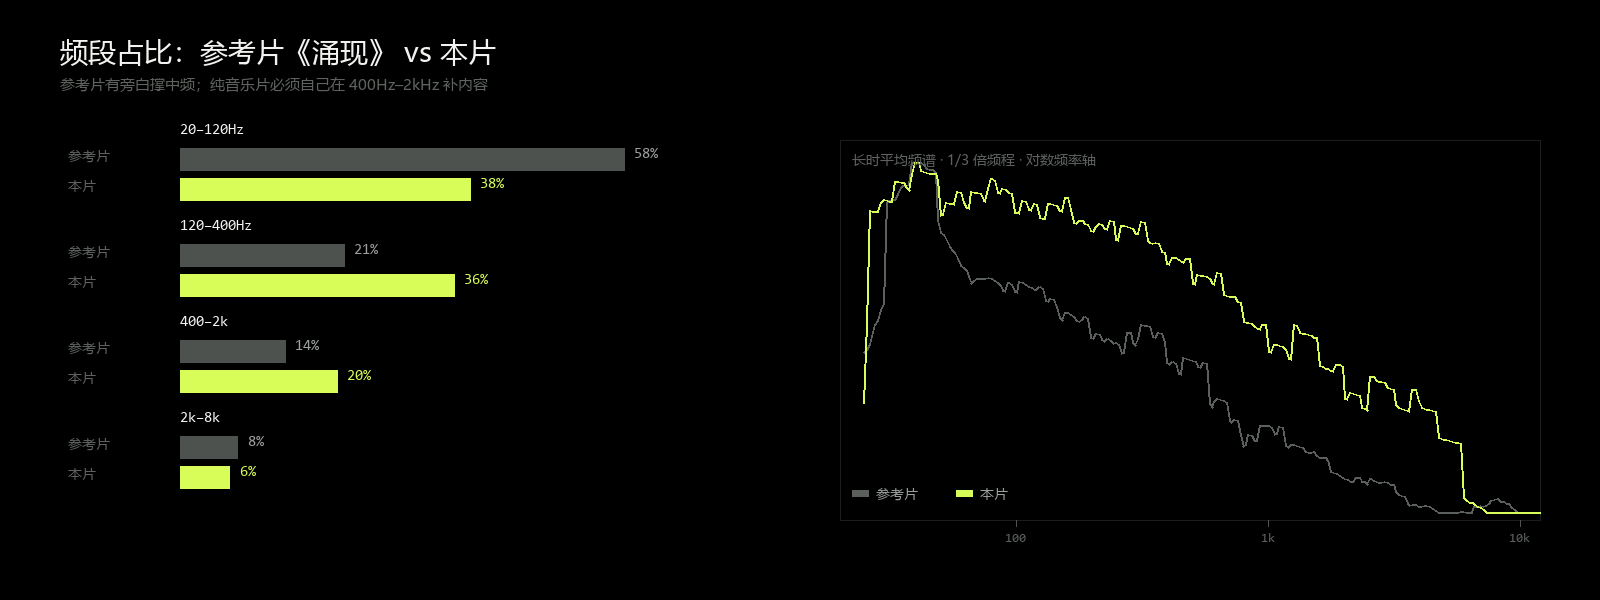
左:四频段占比,参考片 vs 我的片子。右:长时平均频谱。参考片 20–120Hz 占 57.6%,我的是 37.6%——因为它的低频有旁白压着,我这张片子没有旁白,中频必须自己撑起来。
这里我第一次意识到:它可以替我做的,比我以为的多。 我只需要说清「参考它」,它能把「参考」翻译成 BPM、频段、增益表这种我根本不懂的东西。
4. 我的第三次纠正:「太空」是我造的词,它不懂
片子有声音了,我又看了一遍画面。然后我说了第四条:
内容还是太空了,没什么东西,不够震撼
「太空了」——这三个字在我脑子里是有具体所指的。我看的是那支参考片,我记得它每一屏上密密麻麻的东西:一张带坐标轴的图、二十几个数据点、几百只飞鸟、三个红框、底下一行结论、右下角一行参考文献。
但这些我都没说。我只说了「太空」。
它第一次的应对很符合逻辑:加字。字更大、更多、进场动画更花。第二版比第一版更空了——因为屏幕上所有的像素都在说同一句话。
我知道问题在哪了:我在用一个形容词,指望它猜到我脑子里那张具体的图。
于是我换了个问法。我没有说「再加点东西」,我让它去数:
你去把参考片按秒抽帧,一屏一屏看,每一屏上有几个独立的信息元素?列给我。
它数出来了:一屏里有坐标轴、有数据点、有标注、有结论、有出处,至少五样。
而我的片子里,一屏只有一个居中的大字,和一片黑。
这就是「太空」的可数版本。从那一刻起,「太空」不再是形容词,而是一个差值:5 减 1。
接下来那一轮它重写了八场,我一场一场验收:
- 02 我是谁:原来只有一个「Data 人」大字。改成了左边标题 + 右边 12 个分类的真实篇数横条图(金融投资 5 篇、分布式数据库 4 篇……),横条长度就是篇数。
- 03 碎片:原来只有三个词。改成三列真示意图——5 个副本的日志流(
ack 3/5 → COMMIT)、Saga 状态机带红色虚线的补偿边、一个真的在转的 SG90 舵机配角度曲线。 - 07 体量:原来只有三个数字。改成一张 24 篇真实发布时间轴,每个点一篇文章,中间那段 301 天的空窗用斜纹标出来,还叠了一条累积篇数的阶梯线。
- 08 沟:原来只有一道沟。加上了沟壁的深度刻度(0 / 3 年 / 7 年 / 10 年)、四层地层线、46 颗下落的碎屑,沟里写着「没有教程 / 没有老师 / 没有对照组」。
- 09 桥:原来只有一个「跨」字。改成六层知识栈,一个光点从 2010s 往上爬,爬到哪层哪层亮,每层挂着对应的文章标题。
- 10 收束:原来只有两行字。底下补了一条 962 天的证据条:24 根柱子按日期排列,高度是篇幅,最右边一根红色的「第 25 篇 · 在写」。
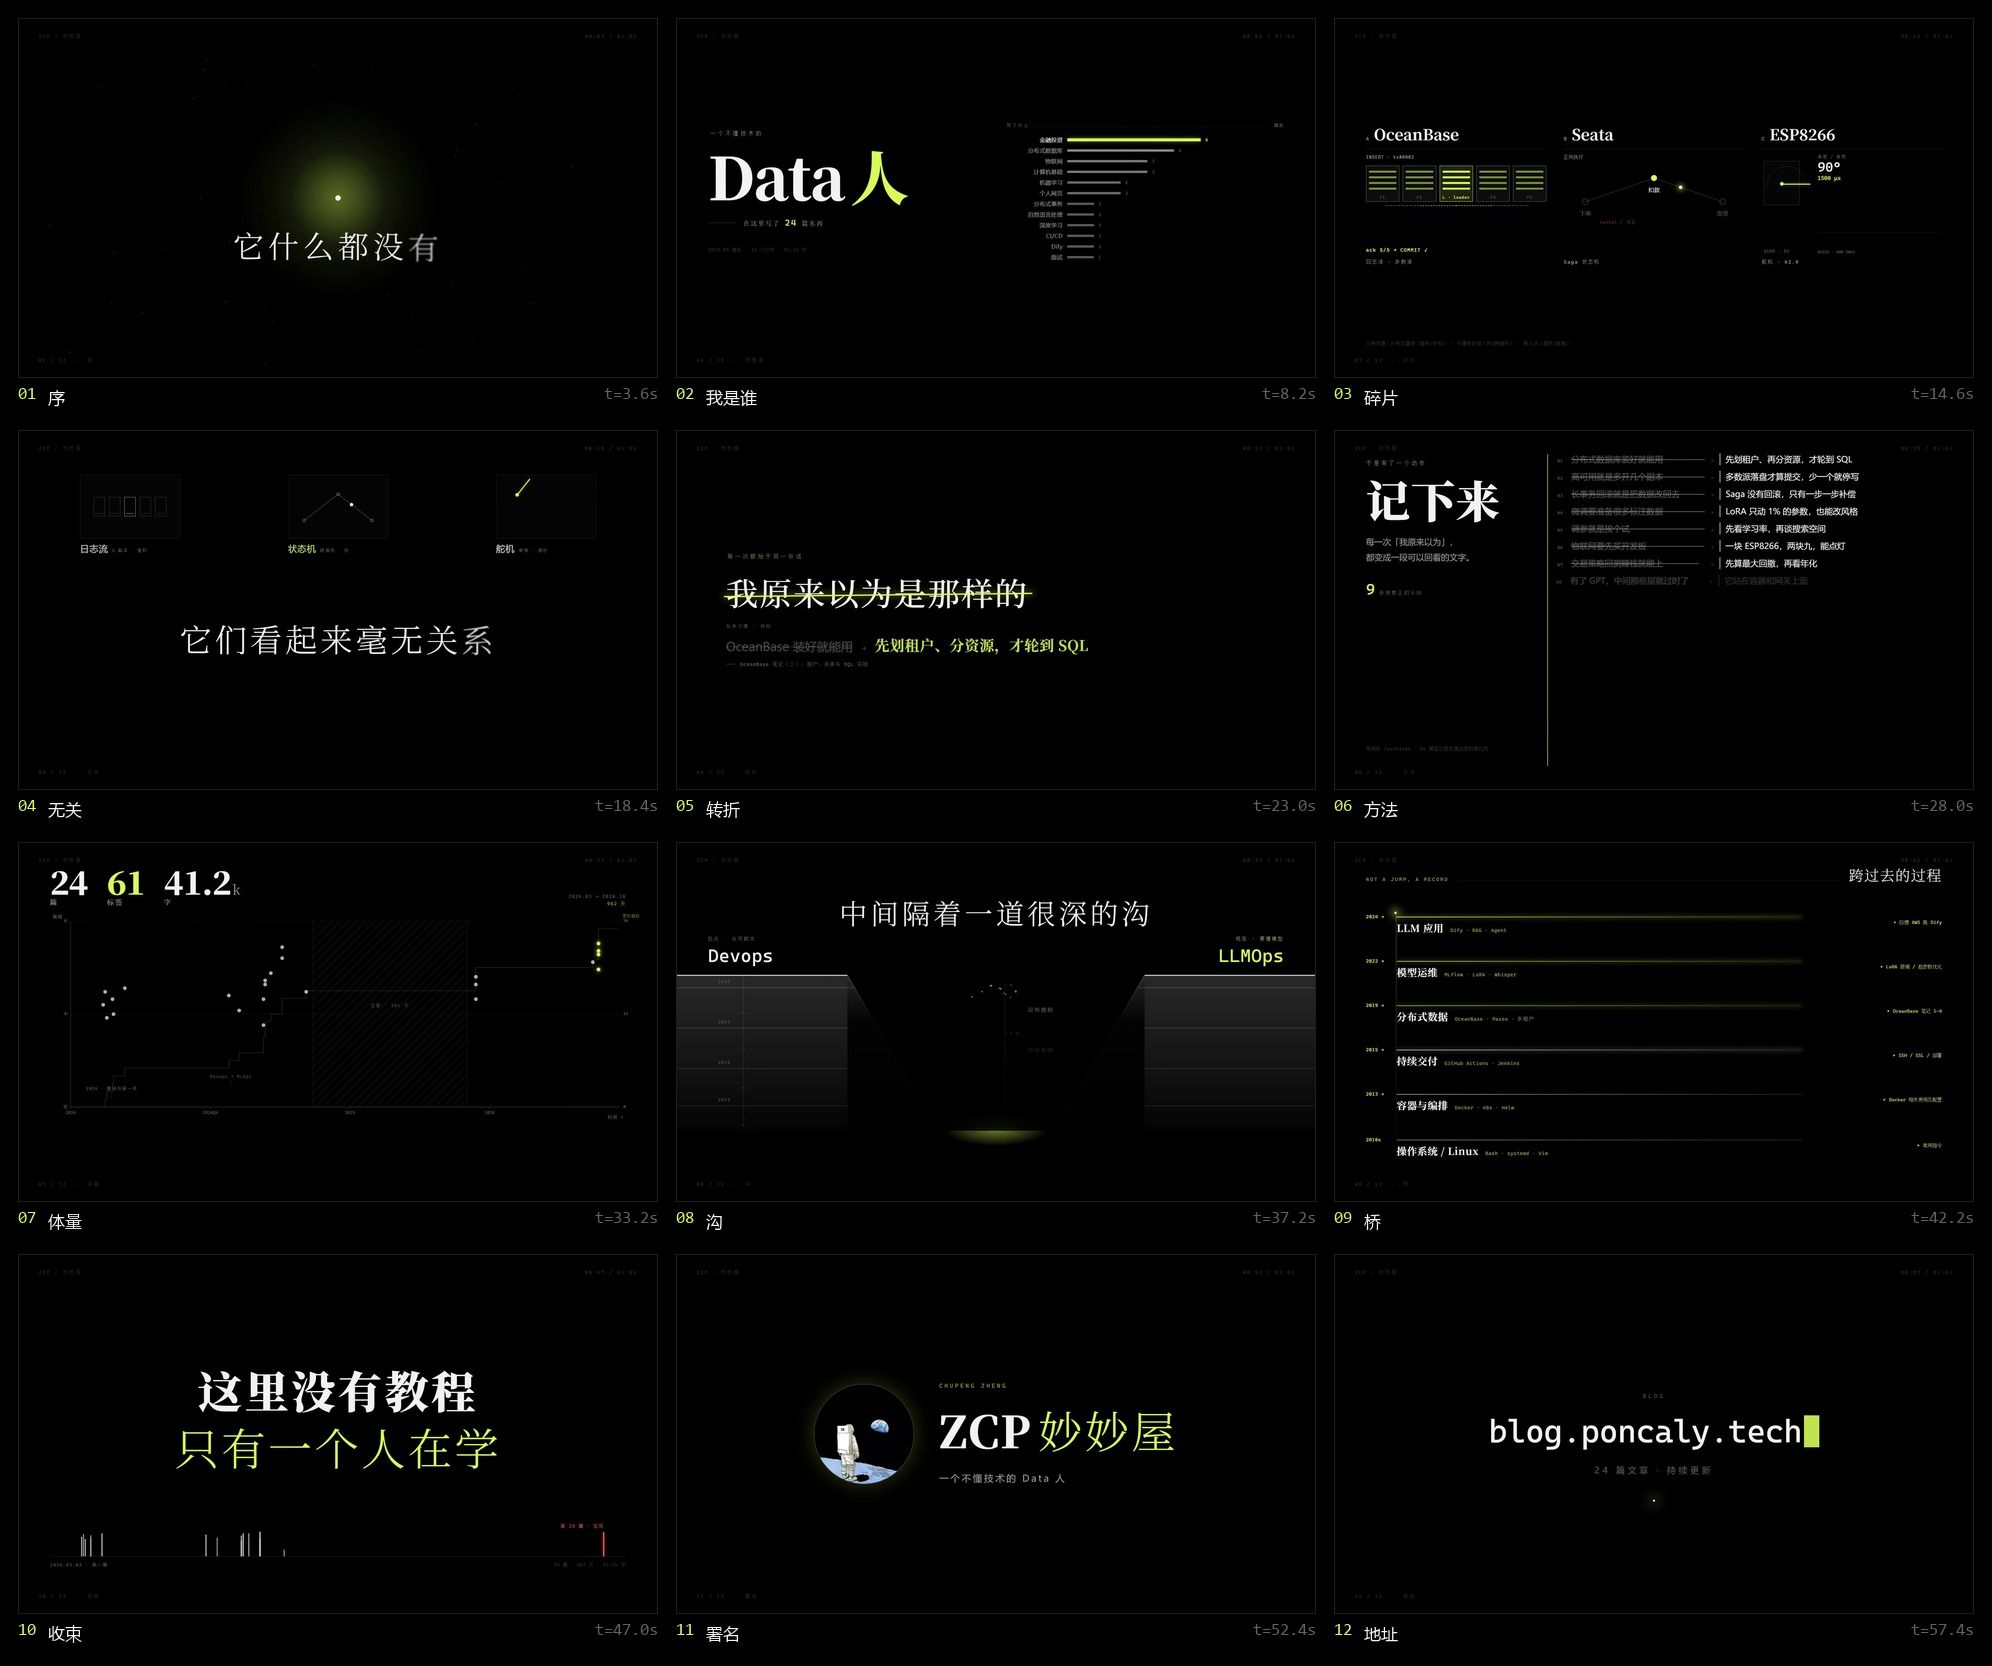
改完之后的十二屏。我每次都用这张图检查:随便挑一格,这一格里有没有一个「只有我这儿才有」的东西。
这一轮之后,片子能看了。
抽象形容词必须被翻译成可数的事实。「震撼」不可数,「这一屏有几个独立元素」可数。你把词换成数,它就知道该干什么了。
5. 我的第四次纠正:框架错了,改内容没用
片子我自己满意了,就想着把这套东西写成教程,发在博客上。
它写了一篇。十五节,结构清楚:为什么不用剪辑软件、装什么、建项目、script.json 怎么排、时间轴怎么对齐 60 BPM、串场怎么做、一屏怎么画、配色字体、动效函数、配乐合成、抽帧调试、出片、踩过的坑、最后一段总结。
技术上全对。代码都是真的,能跑。字数也够,六千字。
我读了两遍,然后跟它说:
我看了你写的,我想看到的不是你如何制作的,我要的是”我”是怎么引导ai做的,所以叫vibe知识,懂了吗
它写的是一份技术文档。我要的是一份人的记录。
这不是内容的问题,是框架的问题。它写的每一段都正确,但那篇东西里没有「我」——没有我的错误判断,没有我说错话的那几个瞬间,没有我为什么在某一帧上停下来重看三遍。
如果我只是说「再改改」「加个例子」「语气再轻松点」,它会在这个错误的框架里改得更精致,离我要的越改越远。
框架错了的时候,「再改改」是有毒的。 它会把你困在一个越来越漂亮的错误方向里。这时候唯一有用的动作是:停下,把框架说清楚,从头来。
所以我让它把 630 行删了,重写。就是你现在读的这篇。
6. 我摸索出来的四条土办法
五次交锋,我总结出四条。都不是什么高深的东西,但每一条我都是用一条废掉的成片换来的。
第一条:给对照物,不要给形容词
「好看」「高级」「有质感」「震撼」——这些词在我脑子里有意义,在它那里等于没说。而「参考这支片子」「照这个站点的排版」是一个可以被拆解、被测量、被复制的东西。
我给的参考片,它拆出了 60 BPM、57.6% 的超低频、每屏五个信息元素。这些都不是我说的,是它量出来的。但它能量,是因为我给了可以量的东西。
第二条:说「不要」的时候,必须同时说「那要什么」
「不要配音」这句话的杀伤力在于它没有终点。它删掉了配音,也删掉了配音顺带支撑的一切——时间轴的长度、每场的节奏、观众注意力的落点。
后来我学会了这么说:不要 A,改成 B,A 留下的坑用 C 填。
第三条:验收要一个数
「听着还是有配音」和「音轨相关系数 0.9999」是两种完全不同的东西。前者会引出「我觉得已经没有了」,后者没有讨论空间。
我现在验收东西会逼自己找那个数:频谱占比是多少、总共多少帧、这一屏有几个元素、渲染花了多少秒。哪怕这个数是我瞎定的,它也比一句感觉有用。
第四条:觉得不对但说不出哪儿不对,先问自己在跟什么比
我有一次盯着第三场看了很久,说不上来哪里怪。后来发现是我脑子里在跟参考片的某一帧对比,而那一帧根本没有被我写进任何一句指令里。
说不出哪儿不对,通常是因为参照物还在我脑子里。把它说出来,问题就自己显形了。
7. 我按下的三次否决
有几件事是它做不到、也不该由它做的。这三次否决,我到现在还记得。
第一次否决:交叉叠化。
它最初做转场用的是标准的淡入淡出——旧的一屏慢慢淡,新的一屏慢慢显。这个做法在任何教程里都是对的。但我抽了第 8.2 秒那一帧出来看,两屏的居中大字叠在一起,糊成了一团。
我来回看了三遍才确定不是我眼花。然后我说:别叠了,旧的先退干净,新的再进。
改完之后中间多了一帧近乎全黑的缝。就这一帧,整支片子的呼吸对了。
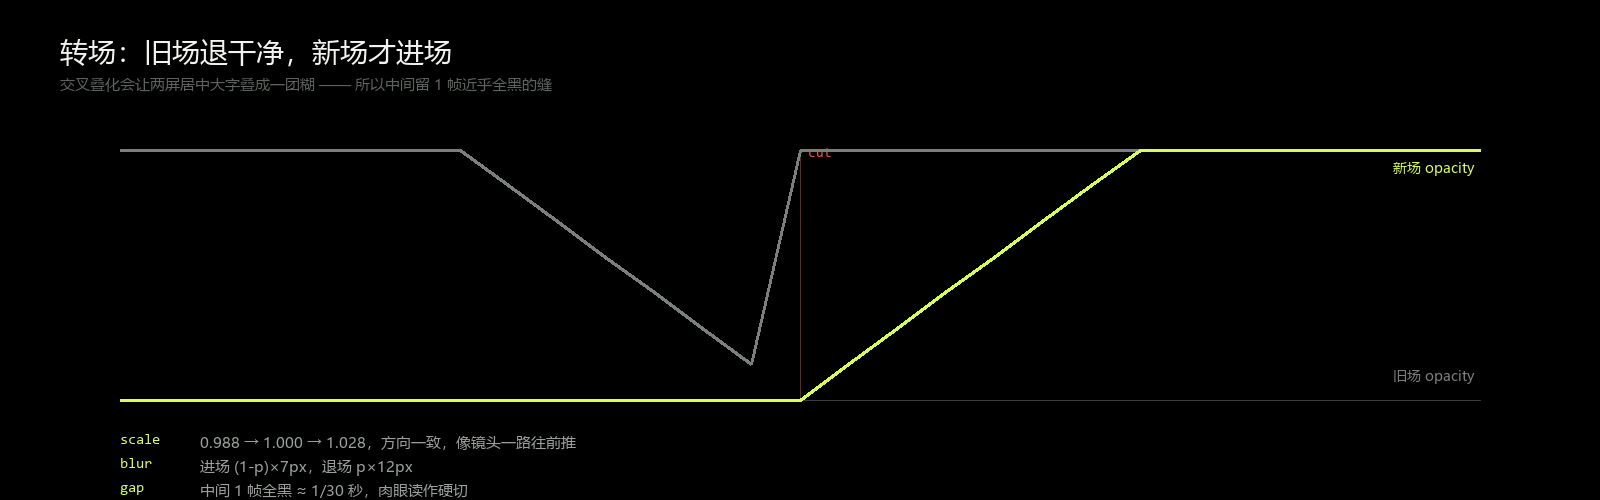
改完的转场:旧场先退干净(7 帧),留一帧黑缝,新场再进(7 帧)。缩放在退场时轻微放大,模糊只在退场和进场时出现。
第二次否决:那十二根灰线。
第六场「记下来」,它右边画了十二根灰色的横线,一根比一根短一点,说是「节奏感」。我看了一会儿,问它:这十二根线分别代表什么?
它答不上来。那就是装饰。
后来这十二根线变成了九条真的「旧认知 → 更正」,每一条都能在我的文章里找到出处。左边是被划掉的旧想法,右边是更正后的。
第三次否决:配音。
这个不用多解释。我戴上耳机听了三遍,才敢确定那不是我的错觉。
这三次否决有个共同点:都是我看了、听了之后做的判断。 AI 没法替我做这件事——它可以算出频谱占比,但它不知道那 8.2 秒的两行字看起来很难受。
8. 那到底什么是「我」做的
片子出来之后我复盘了一下,把「我做的」和「它做的」分开列了一遍。
我做的:
- 选了那支参考片。这个选择决定了片子的上限——我要是选了一支花里胡哨的,后面怎么改都是花里胡哨的。
- 定了「不要配音」。这个决定决定了片子的形态,也决定了后面配乐必须自己撑起中频。
- 数出「一屏五个元素」,把它变成一条可以执行的密度标准。
- 在第 8.2 秒停下来,否决了交叉叠化。
- 看到十二根灰线,问了一句「这代表什么」。
- 听了三遍,确认配音还在。
- 每一次重渲之前,按下那个回车。
- 以及,写下这篇东西。
它做的:
- 3600 行 tsx,二十个文件。
- 把「参考它」翻译成 60 BPM、八层配器、增益表、
loudnorm。 - 把 24 篇文章的日期和篇幅变成一张时间轴。
- 每次改完自己跑类型检查、自己抽帧、自己把错误修掉。
- 我要它删 630 行,它删了。
我数了一下,我为这支片子说过的有效指令,大概二十来句。它写下的代码,3600 行。
vibe 不是「我说得少」,是「我判断得准」。 我说得少,是因为大部分活儿它确实能干;我判断得准,是因为每一句否定背后,我脑子里都有一张具体的图。
9. 如果你也想这么干
五条,按重要性排:
一、先找到那支「就是这样」的片子。 不是「大概这种感觉」,是具体到某一支、某一帧。这一条的价值比后面四条加起来都大。
二、把你的不满意说成事实,不要说成情绪。 「太空了」可以用,「第三场除了标题还有别的东西吗」更好用。
三、接受你会说错话。 我五次里有四次说的是「不对」。这不是失败,这就是这个过程本来的形状。
四、让它自己验收。 类型检查、抽帧、量频谱、算相关系数——凡是能变成数的,都让它交数给你。
五、框架不对就重来,不要打补丁。 这一条最贵,也最省时间。
10. 片子在这儿
61.4 秒,1080p,三十帧,没有旁白,-11.7 LUFS。
如果你看完觉得「还行」,那这里面大概有二十句我说的话,和三千六百行它写的代码。分工就是这样。
参考片:《涌现·参试的史诗》(B站,我最喜欢的一支)。技术栈:Remotion + React + TypeScript,配乐用 numpy 从零合成。整套工程 3640 行,二十个 tsx 文件。